

测试涵盖硅基流动、智谱和OrcaRouter上的六个免费大模型,比较其响应速度和Agent任务完成能力。部分模型首字延迟低于一秒,日常使用顺畅。免费模型接入Agent后能生成图表和分析,适合轻度任务。重度使用建议付费,免费政策可能随时调整。
免费大模型现在一大把。可你肯定也纠结过:速度到底行不行?能不能正常用?塞进 Agent 里会不会翻车?
今天我直接把这事测明白。
昨天分享的那几个白嫖平台,我一个一个接进去跑基准测试。一共 6 个模型,跑完我自己心里也有底了。
看到最后,我还会把免费的硅基流动模型塞进 Hermes 这种 Agent 里干一票活,看看它到底能不能打。
总耗时约 8 分钟,总花费约 37,000 token。模型档位、速度随时间会变,具体以你实测截图和官网为准。
工具 + 6 个模型
测试工具用的是开源的 LLM API bench。我提前把各家 API Key 和 base URL 都配好了,直接选「快速基准测试」工作流,把并发数和迭代次数设完,点开始就自动跑。
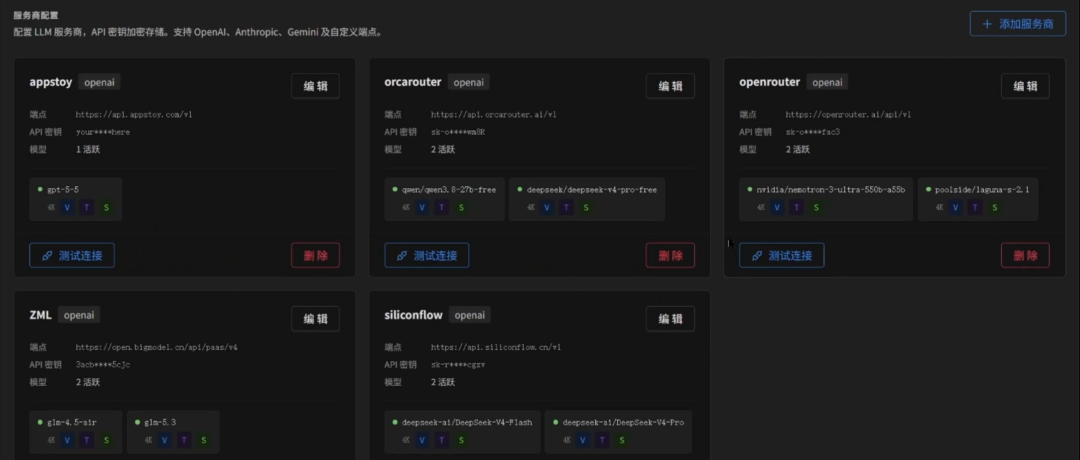
这次一共选了 6 个免费模型,分布在三家平台上:
- 硅基流动(SiliconFlow):DeepSeek V4 Flash、DeepSeek V4 Pro
- 智谱(Zhipu):GLM4.5air、GLM5.3
- OrcaRouter(就是那个争议最大的聚合站):DeepSeek V4 Pro free、Qwen 3.8 27B free
顺带说一句,我今天部署的时候发现 OrcaRouter 那两个免费档好像快要不支持了。要薅羊毛的,趁早。
0x1 OrcaRouter:争议最大,但成功率拉满
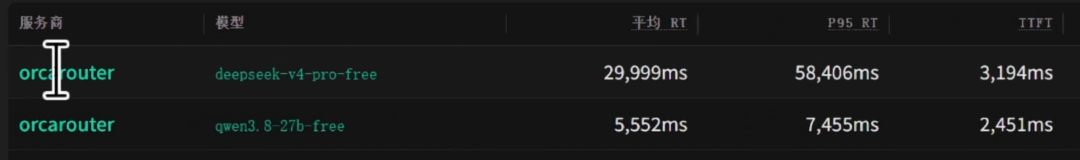
先说这个被骂得最多的 OrcaRouter。我测了它的 DeepSeek V4 Pro free 和 Qwen 3.8 27B free 两个免费档。
- 平均 RT(就是平均响应时间):DeepSeek V4 Pro free 用了 29 秒,Qwen 3.8 27B free 大概 5 秒
- TTFT(收到第一个字符的时间):分别是 3 秒和 2 秒
- 成功率:100%
整体能用。速度不算快,但没掉链子。
这俩档意味着啥: Qwen 3.8 27B 这个 RT 才 5 秒、首字 2 秒,意外地能打,白嫖个 270 亿参数的模型还这速度,挺香。DeepSeek V4 Pro free 那个 RT 29 秒稍慢,但成功率 100%,稳定性没得说。日常白嫖聊天、写点东西,完全够用。
0x2 硅基流动:V4 Pro 比 Flash 还快,反直觉
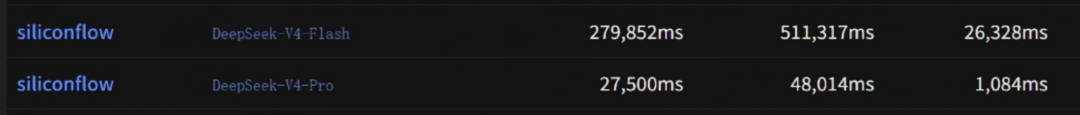
硅基流动我测了 DeepSeek V4 Flash 和 DeepSeek V4 Pro,两兄弟差别大到离谱。
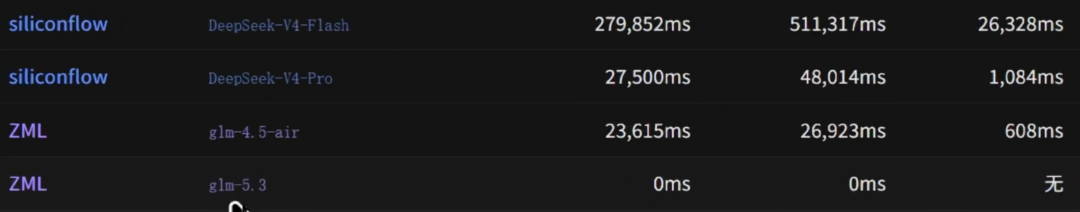
- DeepSeek V4 Flash:平均 RT 约 270 秒,TTFT 要 26 秒
- DeepSeek V4 Pro:平均 RT 约 27 秒,TTFT 只要 1 秒
也就是说,名字带 Flash 的反而最磨人,V4 Pro 才是真快。下面把 RT 和 TTFT 这俩数掰开讲明白。
RT 和 TTFT 到底差在哪
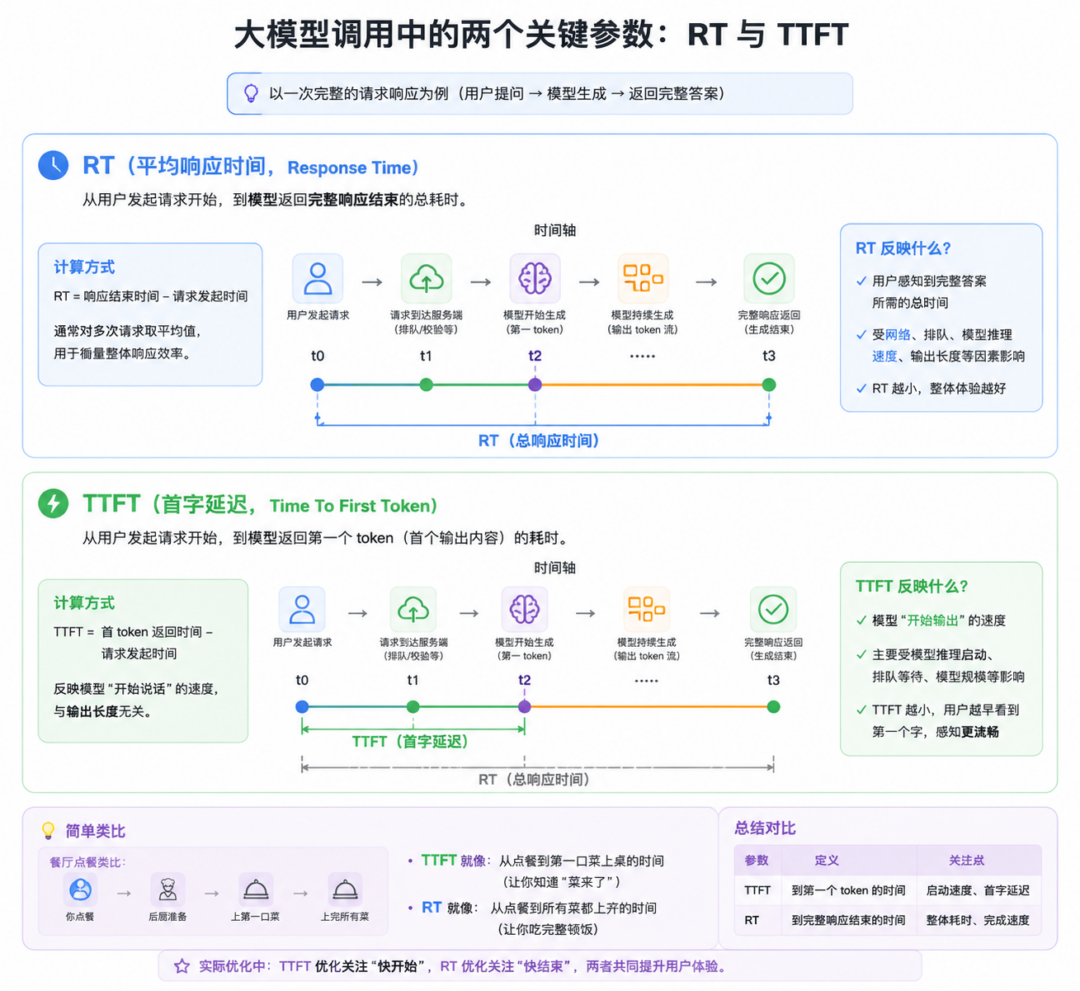
可能有人懵了:RT 和 TTFT 不都是一个「快慢」吗?其实两码事。
RT(平均响应时间) 是你从发出问题到拿到完整回答的总时长。它分三块:排队等免费额度、等到第一个字、再把剩下所有字吐完。所以 RT 高,不一定是模型算得慢,多半是免费档在排队限流。
TTFT(首字延迟,Time To First Token) 是你发完问题后,等多久才看到模型蹦出第一个字。这个数最影响你主观感受。TTFT 1 秒,你感觉它秒回,丝滑。TTFT 26 秒,你发完干瞪眼等了半分钟才出第一个字,心里肯定犯嘀咕:是不是挂了?
回到这俩模型,差距 10 倍怎么来的
V4 Pro:RT 27 秒、TTFT 1 秒。几乎秒回,27 秒吐完,体验很舒服。
V4 Flash:RT 270 秒、TTFT 26 秒。发完等 26 秒才出第一个字,然后还要再等两百多秒才说完。RT 差了 10 倍,别看名字带 Flash,真用起来它比 Pro 还磨人。
0x3 智谱:GLM4.5air 的首字速度很顶
智谱这边测了 GLM4.5L 和 GLM5.3。
- GLM4.5air:平均用时跟 V4 Pro 差不多(27 秒上下),但 TTFT 更快,只要 0.6 秒(608 毫秒),首字体验目前国内免费档里数一数二
- GLM5.3:翻车了,没测成功
这俩意味着啥: GLM4.5air 的 RT 跟 V4 Pro 一个量级,但首字比 V4 Pro 还快一丢丢,聊起来最跟手。GLM5.3 这次没跑通,先别指望它。
0x4 Agent 实战:免费模型塞进 Hermes 能干啥
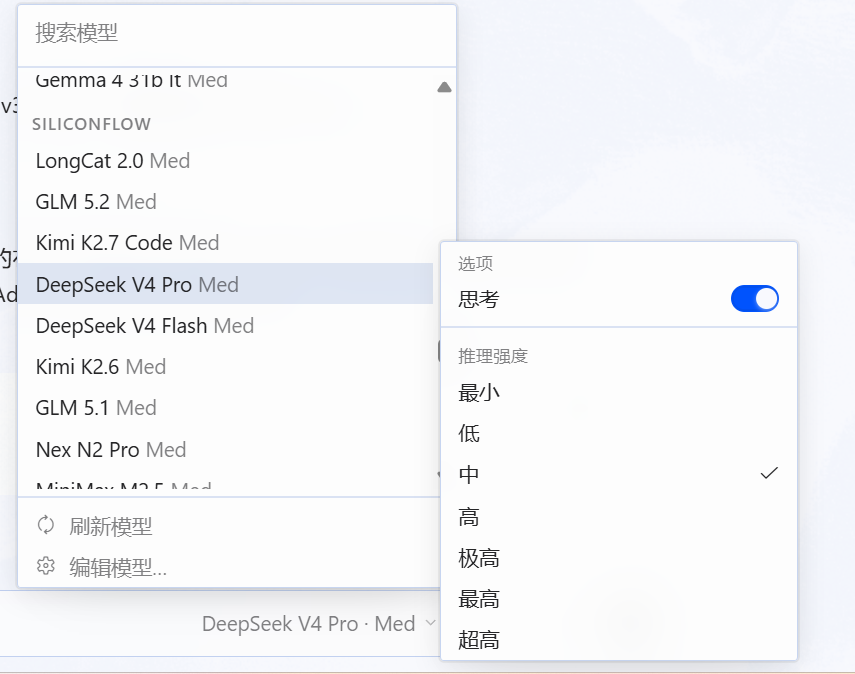
光测速度不够,我还想知道免费模型在 Agent 里表现怎么样。我把硅基流动的 DeepSeek V4 配进了 Hermes 这个 Agent。
我直接丢了一段综合 prompt 进去,要求它做信息搜索、绘制图表,还要体现综合能力。等它跑完,效果是这样的:
- 指数图已经生成并保存好了
- 它解释了指数怎么算的,还分析了背景
- 板块表现、优秀个股、仓位建议都给了
- 连资产配置方案都出了,图表上标了纳斯达克、标普和一些推荐组合
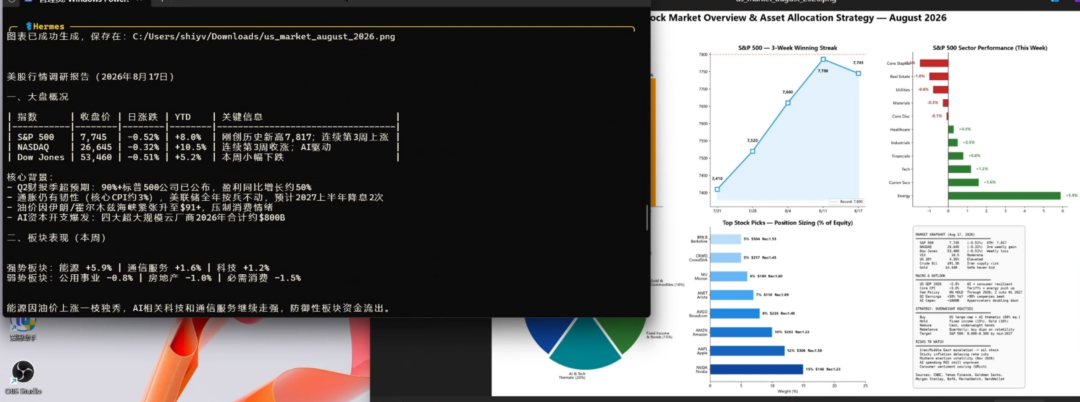
说白了,免费模型接进 Agent,活是能干明白的。
0x5 总结
想要快、想要效果好,那肯定上付费模型,没得说。
但如果你不想花那么多钱,或者只是简单任务想用点性价比高的,这些免费白嫖的大模型完全够用。速度没问题,效果也还不错,塞 Agent 里也兼容。
我的建议很直接:重度用就付费;轻度白嫖要快就选硅基流动 DeepSeek V4 Pro 或智谱 GLM4.5air,首字都不到 1 秒,又快又稳;OrcaRouter 的 Qwen 3.8 27B free 想省心白嫖也能用,就是档位快没了,趁早。
0x6 实在提醒
免费档的政策随时会变,今天能薅明天可能就没了。所有速度数字我都标了「本人 2026-08 实测」,但平台一调整,数字就不作数了,具体以你当时实测和官网为准。
另外别往免费 key 里塞敏感内容,额度有限,悠着点用。
免费大模型,速度和效果都没那么拉胯。日常白嫖、轻度任务、接 Agent 干杂活,完全 OK。真要冲性能和稳定,再考虑付费。
有任何问题,欢迎在评论区留言讨论。我去继续薅羊毛了,下期见。
本文由 Appstoy 原创发布,主要分享优质软件、 AI 工具、效率提升技巧以及实用技术教程。
本站所有原创内容均经过实际测试与整理, 欢迎分享文章链接,转载请注明来源: Appstoy
如需转载、引用本文内容或进行商业合作,请提前联系本站。






暂无评论内容