

为应对云端成本与隐私问题,可在8G显卡本地部署Qwen3.5 9B模型。该方案支持离线运行并具备工具调度能力。
实测显示本地模型能完成写作与简单编程,但推理速度较慢。其适于应对涉密数据与控制成本,复杂任务仍需依托云端。
很多玩 AI 的朋友最近经常在群里问我同一个问题:看你天天拿各种 Agent 又是写代码又是剪视频,跑得飞起,这背后的 Token 账单到底得有多吓人?
说实话,前几天我顺手点开自己的用量面板看了一眼,连我自己都有点心虚:光是最近 7 天,我一个人断断续续跑下来,就消耗了整整 358M 的 Token,换算成美金是 28.68 刀。要是录视频当天任务稍微复杂一点,单日直接能刷走 7 块钱美金。
除了账单肉疼,还有一道更要命的坎:隐私。手头有些核心的项目代码、私密文档或者客户的真实资料,哪怕云端大模型再聪明,我是真的不敢随手往外扔。
今天给大家推荐一个零成本、数据彻底不离网的硬核解法:用 Hermes Agent 在消费级 8G 显卡上,一键部署并驱动本地 Qwen3.5 9B 大模型,真正做到断网可用。
这功能非常好用。它不仅不需要你敲一行命令去折腾复杂的编译环境,甚至把读文件、查资料这些完整的 Agent 能力全带齐了!
1. 账单刺客
以往我们用各种云端 API,最让人心里打鼓的就是计费黑盒。
当你在后台挂着几个 Agent 跑长任务的时候,谁在疯狂消耗 Token、上下文有没有命中缓存,根本很难做到心中有数。这次我通过自己搭建的中转监控面板,把后台账单拉出来完整核算了一遍。
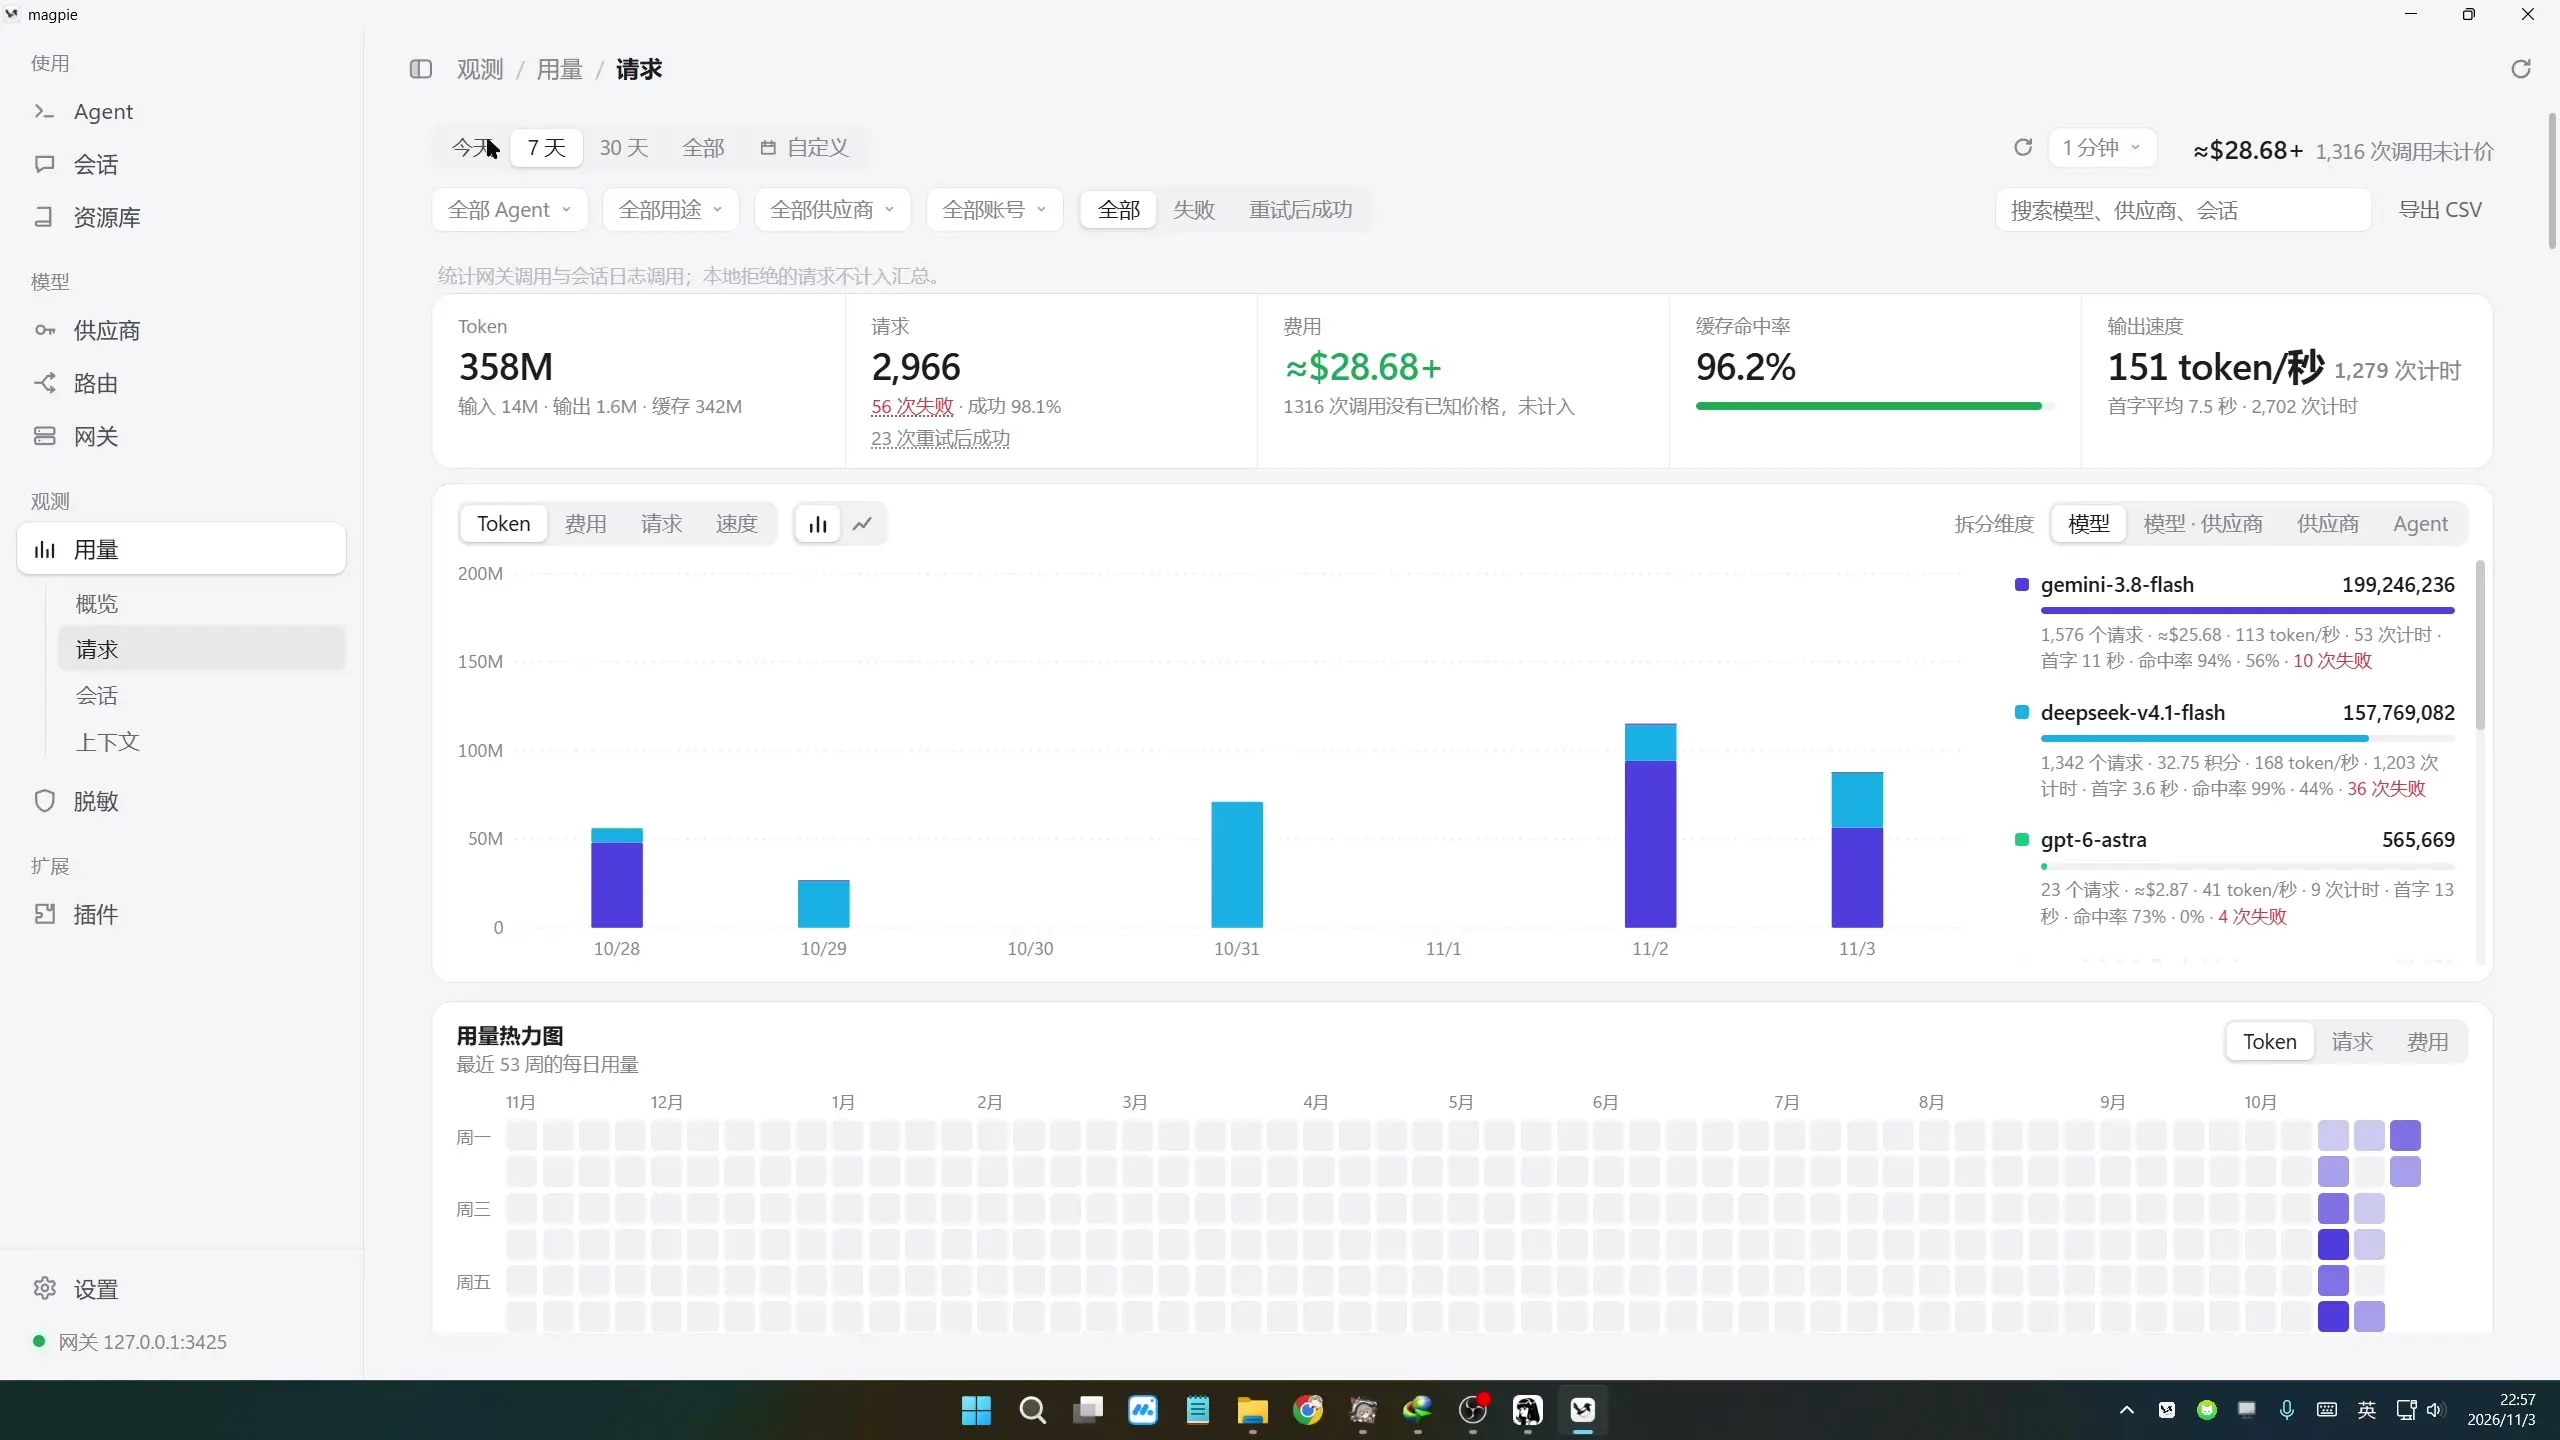
下面是重点:7 天一共发起了 2966 次请求,总 Token 消耗突破 3.58 亿。虽然上下文缓存命中率高达 96.2%,已经算是极其省钱的跑法了,但总计花费依然达到了 28.68 美元。关键这还只是我平时测试、写写教程的日常消耗,一旦遇到复杂的批量清洗任务,费用更是指数级往上窜。
如果你在日常折腾里也经常面临 Token 额度告急、看着钱包心疼的问题,推荐顺手看看我之前写过的多模型聚合池搭建实测:
一边是肉疼的账单,另一边是涉密文件根本不敢往外传的顾虑。两相权衡之下,在本地电脑搭建一个零成本、完全自主可控的大模型,就成了每个发烧友最值得折腾的方案。
2. 选型底牌
装本地模型的路子很多,Ollama、LM Studio、自己拉源码编译 llama.cpp 都行。我最后选 Hermes,理由很实在:
- 一键安装:底层的编译环境、CUDA 依赖和 llama.cpp 运行时全部打包成了一个按钮,不需要在终端对着一堆报错死磕。
- 多端生态:Hermes 最近推出了移动端,电脑和手机能跨端联动,交互逻辑是一致的。
- 全功能 Agent:能读写本地文件、能联网、能调用各种工具。本地模型只有带着工具链,才能真正成为生产力。
先交代一下我这次测试所使用的硬件底子:处理器搭配 NVIDIA GeForce RTX 4060,专用显存刚好 8.0GB,系统内存 31.8GB。这套配置非常有参考价值,几乎对标了目前绝大多数普通游戏本或主流家用台式机。
打开 Hermes 的本地模型中心,你能看到各种参数规模的开源模型。很多新手一上来就奔着大参数去,觉得越大越好,但我劝你千万别踩这个坑。
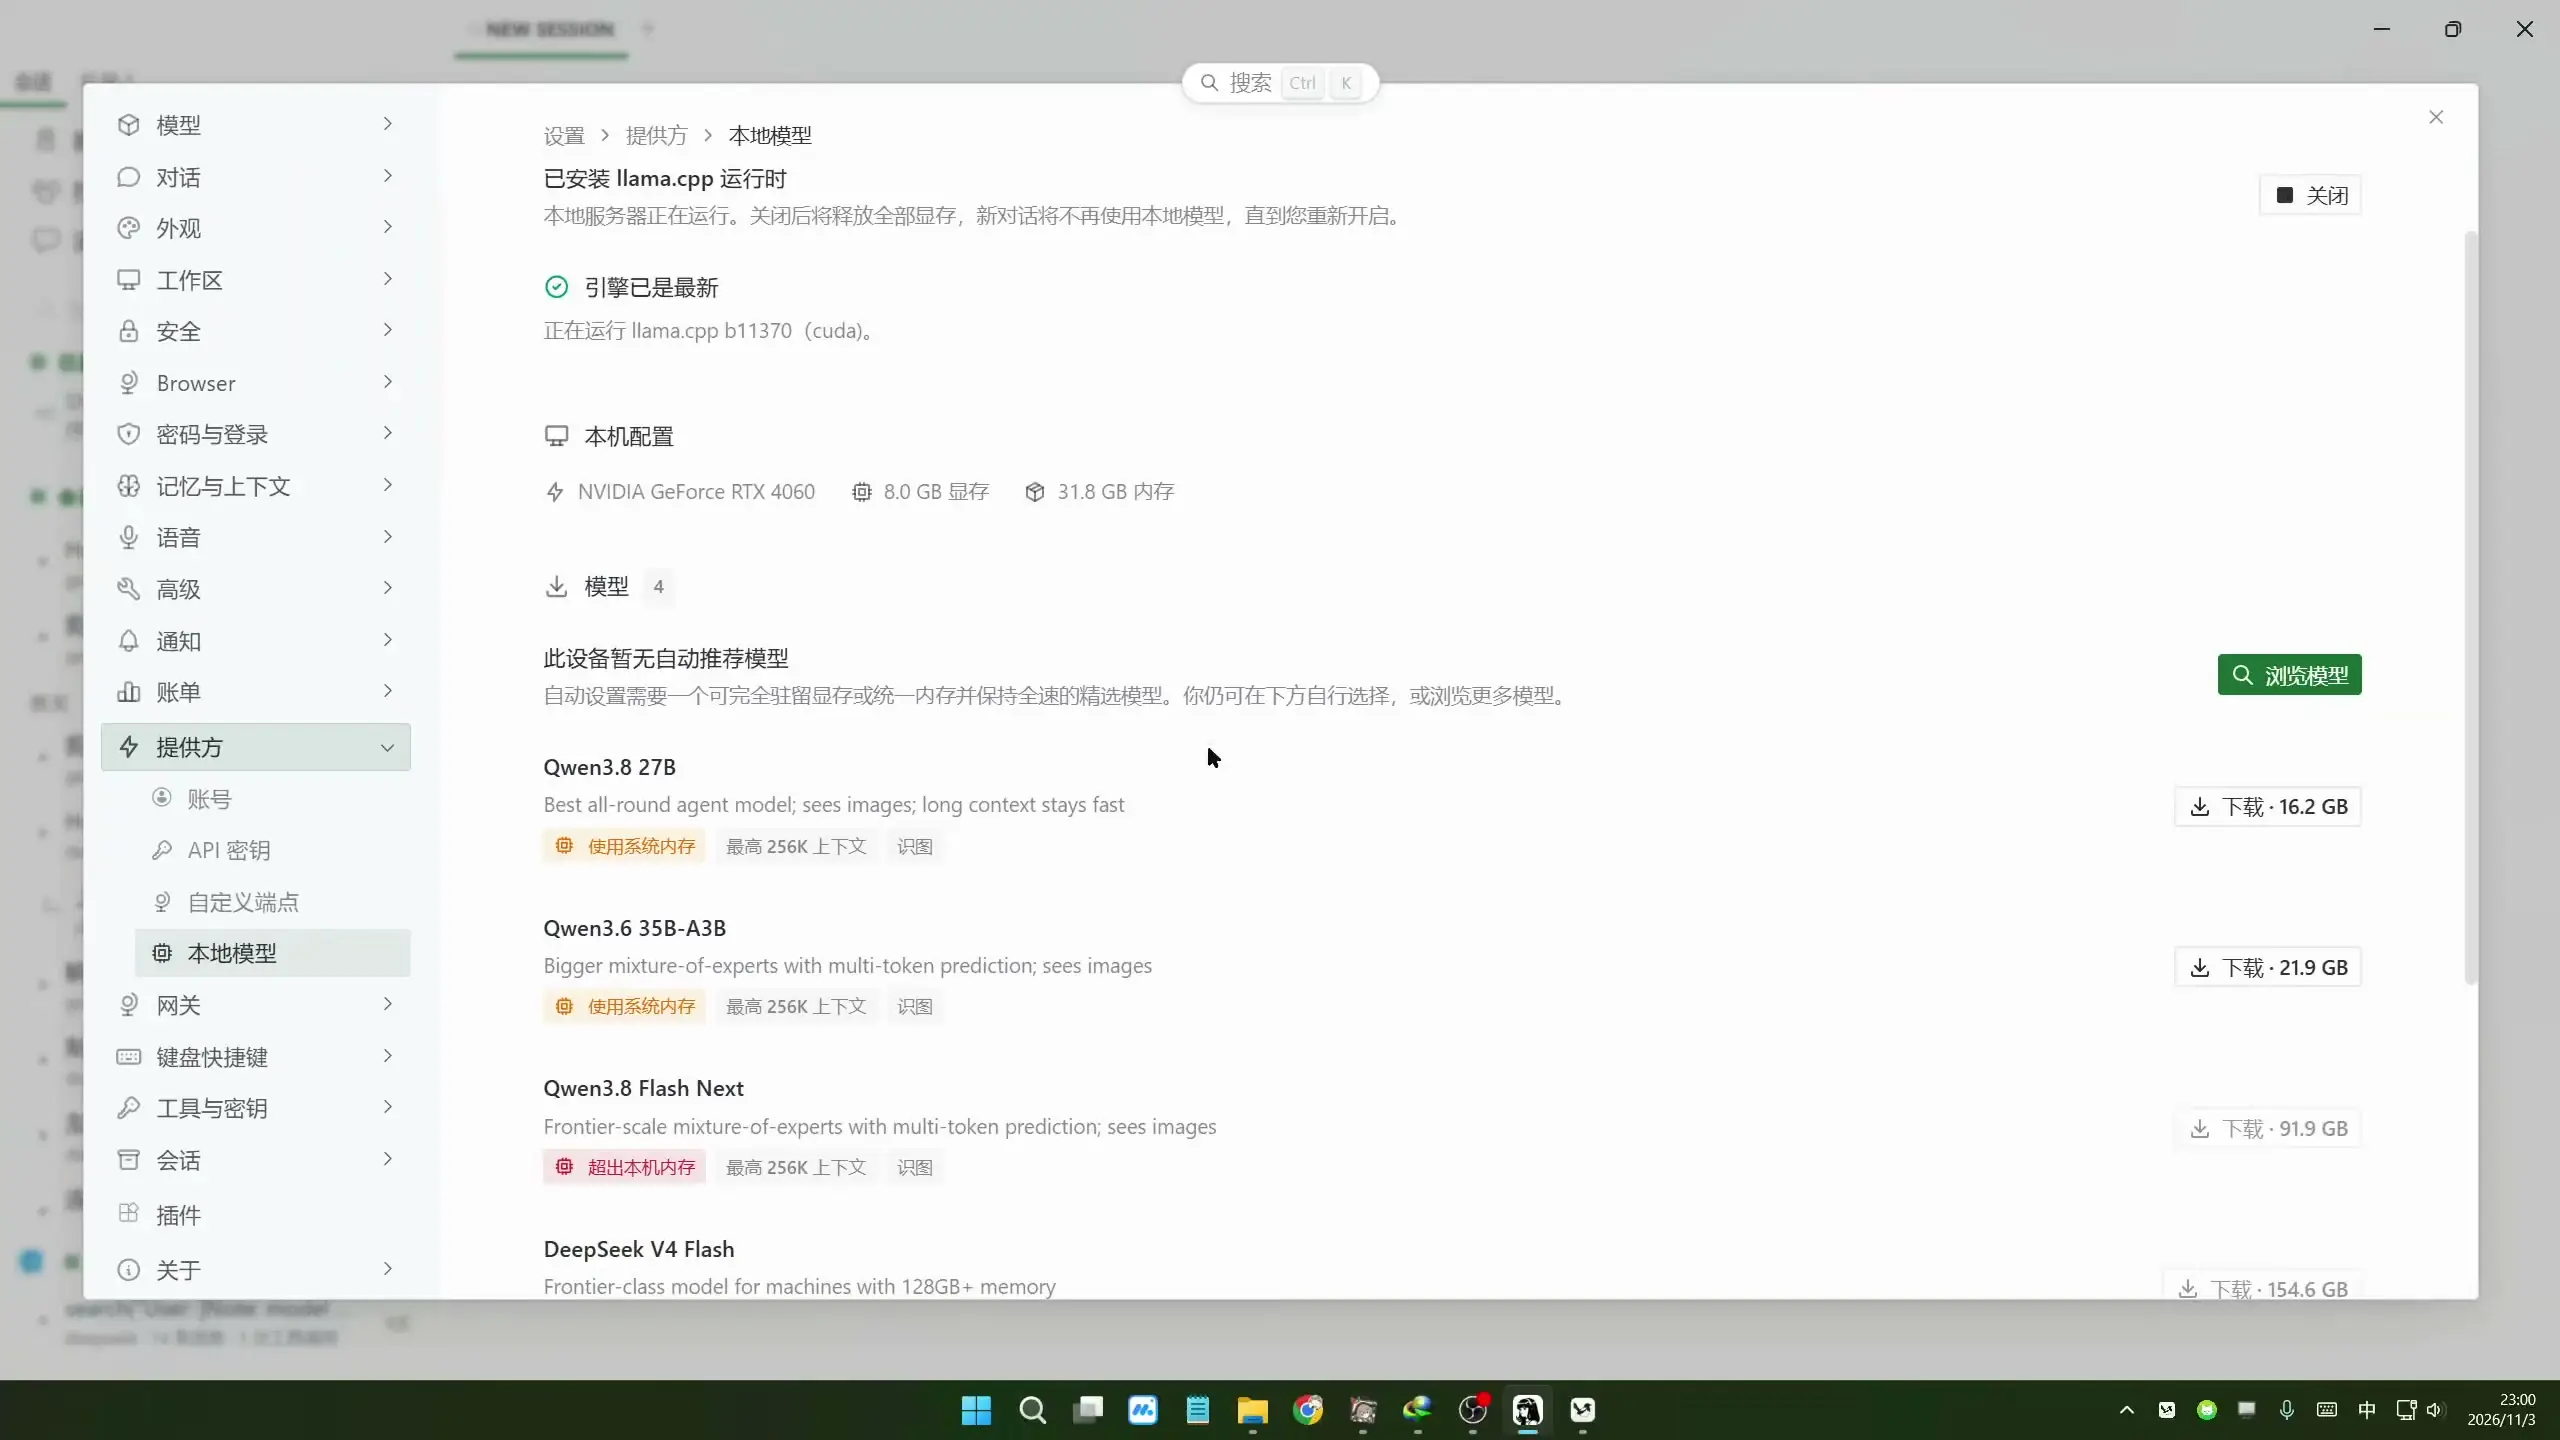
界面里标得很清楚:Qwen3.8 27B 仅下载权重就需要 16.2GB 空间,运行时显存要求更高;更大一点的 35B-A3B 则需要 21.9GB。
很多朋友可能会问:显存不够用,不是能自动借用系统内存吗?确实可以。但在实际运行中,一旦模型权重从显存溢出到内存,带宽就会瞬间从数百 GB/s 骤降到内存的几十 GB/s。结果就是推理速度断崖式崩塌,原本能流畅吐字的模型,会慢到像十几年前拨号上网一样卡顿。
也就是说,在 8G 显存这道物理红线面前,最清醒的甜品级选型就是 9B 左右、Q4 级别量化的小模型。别盲目贪大,能在显存里全部吃下、跑出全速才是王道。
3. 四步安装
整个配置过程完全是在图形界面里点选,一步命令行都不用敲:
- 安装客户端:装好 Hermes 客户端本体。还没装好的朋友可以先参考我之前的旧文:
- 定位面板:点击右上角设置齿轮,在左侧导航找到「提供方」,往下划到「本地模型」。
- 安装运行时:找到内置的 llama.cpp 运行时,直接点击一键安装。装好后会多出一个绿色的运行开关,随时开启、随时关闭。关闭后能瞬间彻底释放显存,完全不占后台资源,这功能非常好用。
- 导入模型:可以直接在发现列表检索下载,也可以像我一样,提前在 Hugging Face 上下载好 GGUF 格式的量化包,点击界面上的「添加模型文件」进行本地导入。
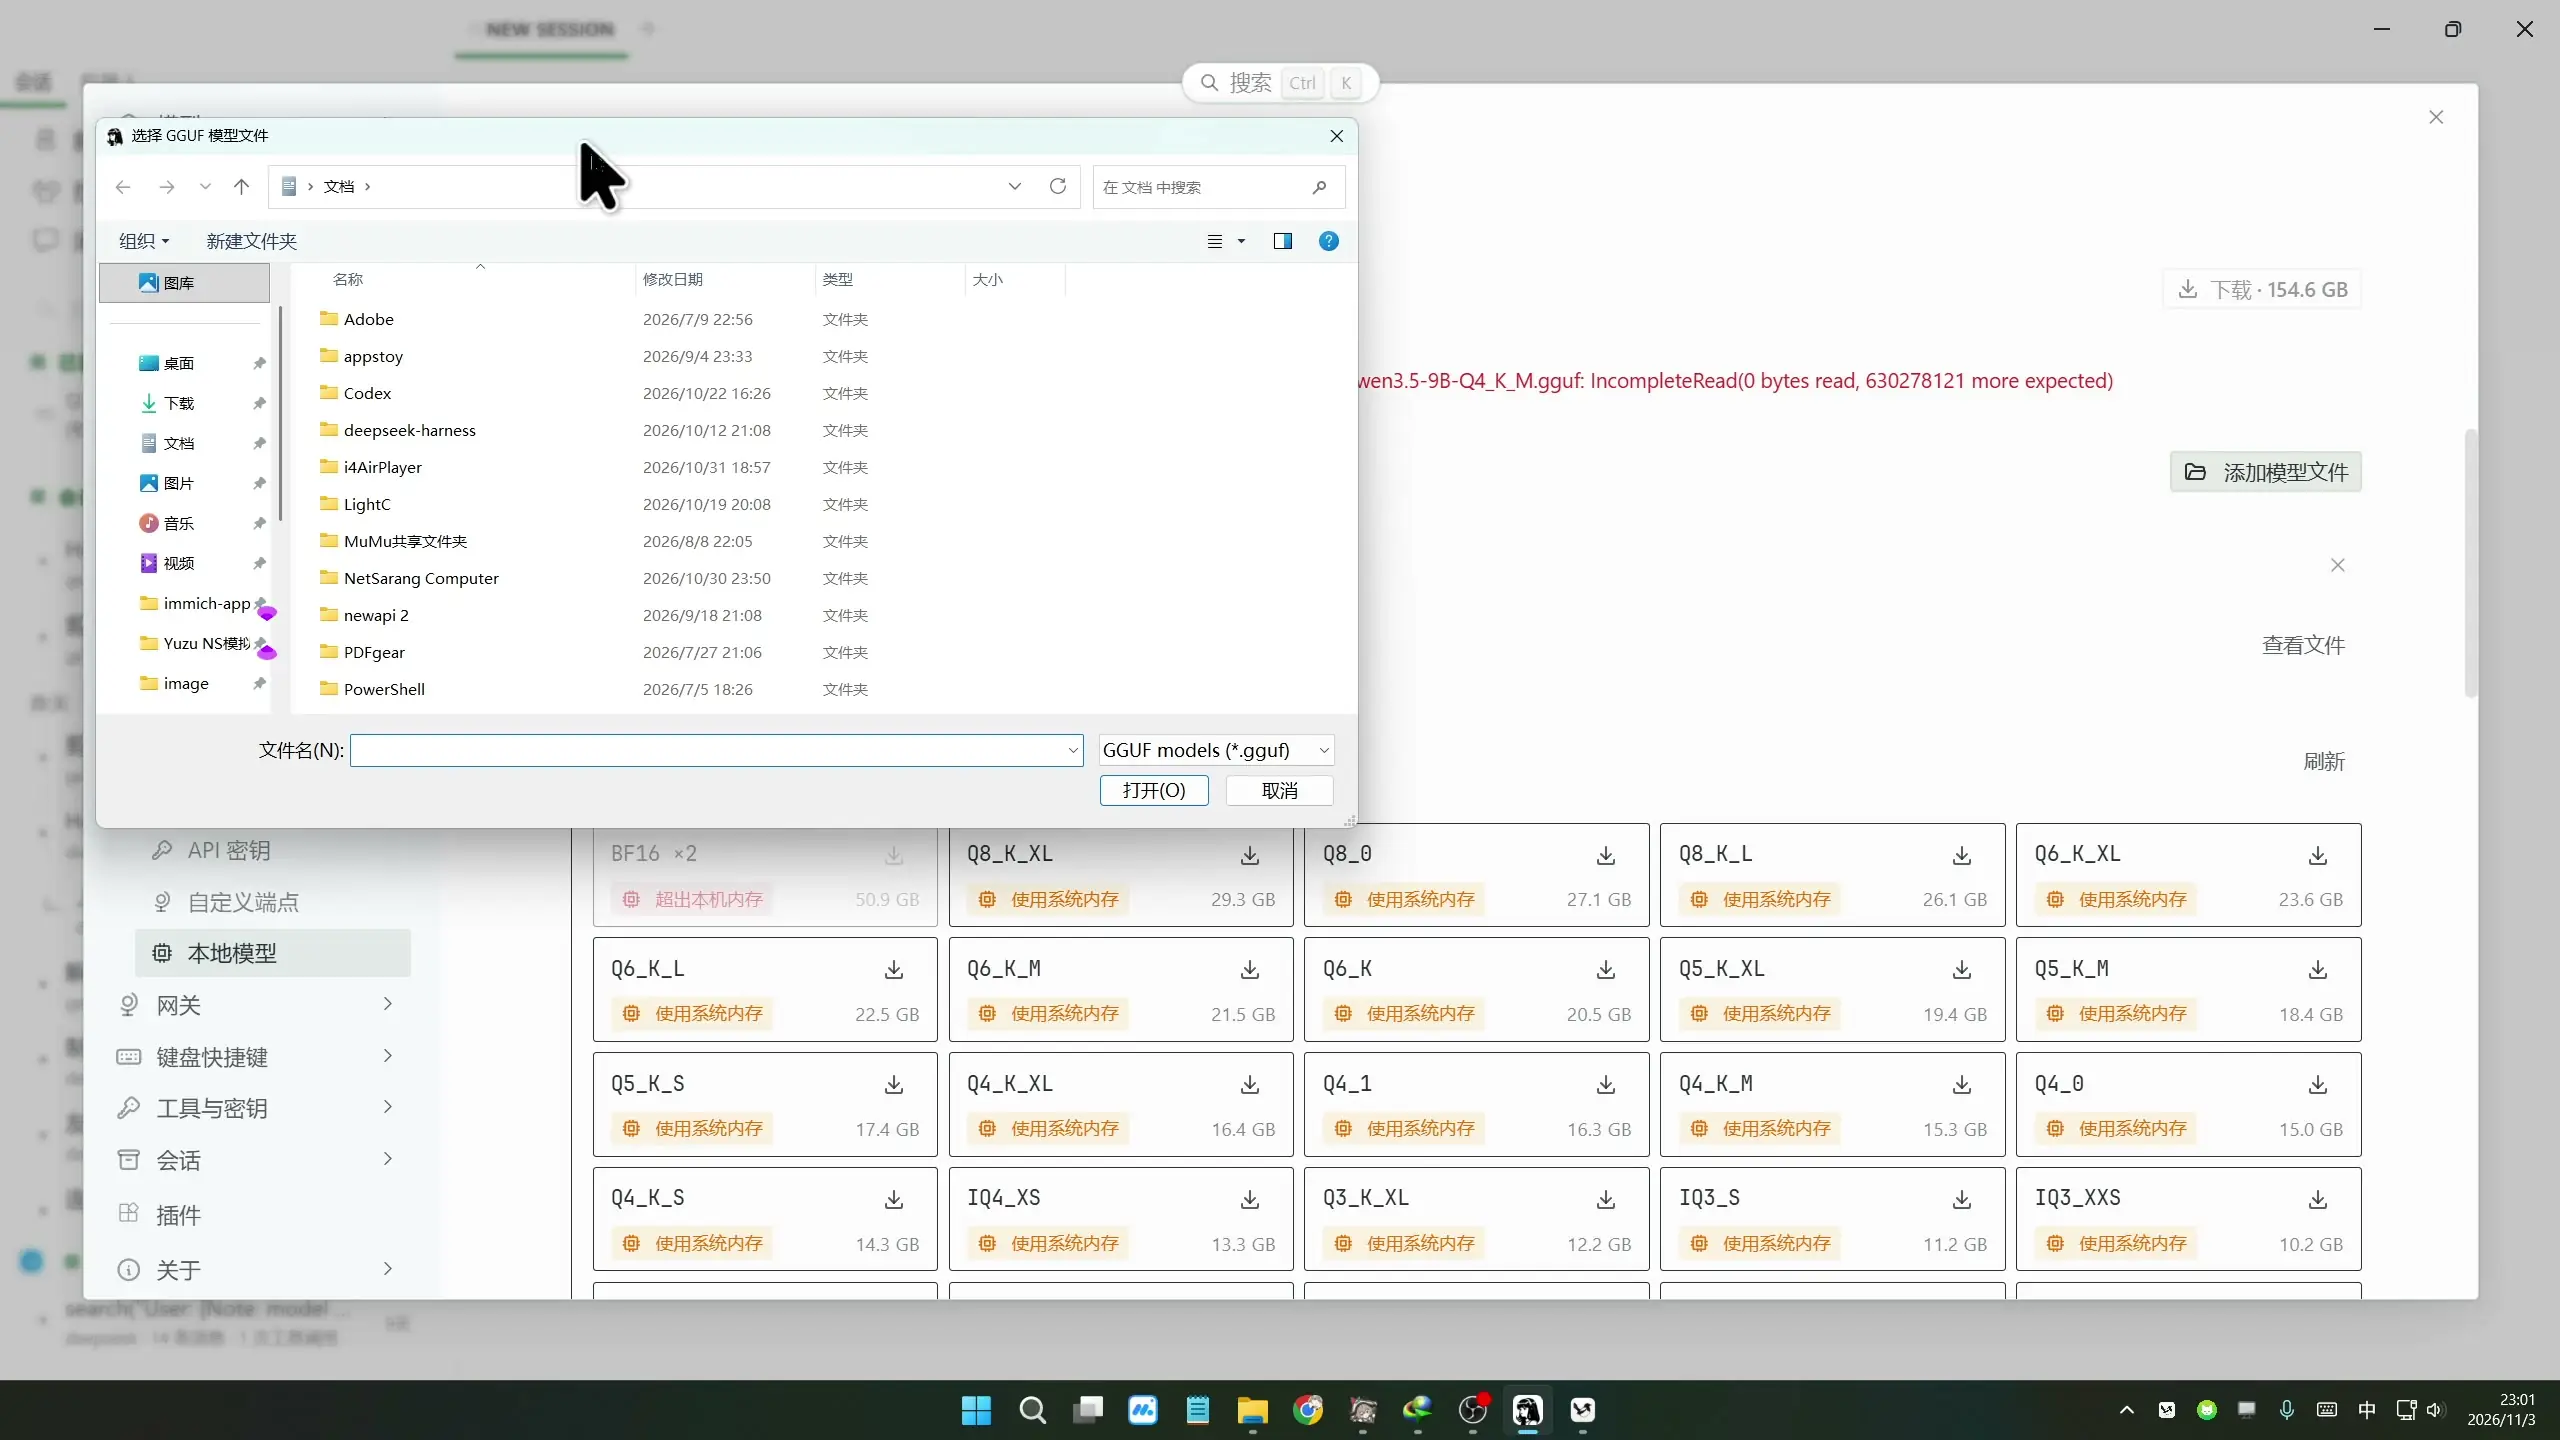
找到刚刚导入的 Qwen3.5 9B,轻轻点一下「使用」,新建会话就会自动切到本地引擎。万幸的是,这一步最容易劝退人的地方——环境变量、CUDA 依赖冲突,全都被这个运行时在底层包揽了。
4. 首次测试
切到本地会话后,我发出的第一句话是经典的压力测试:「你好,你是什么模型?」
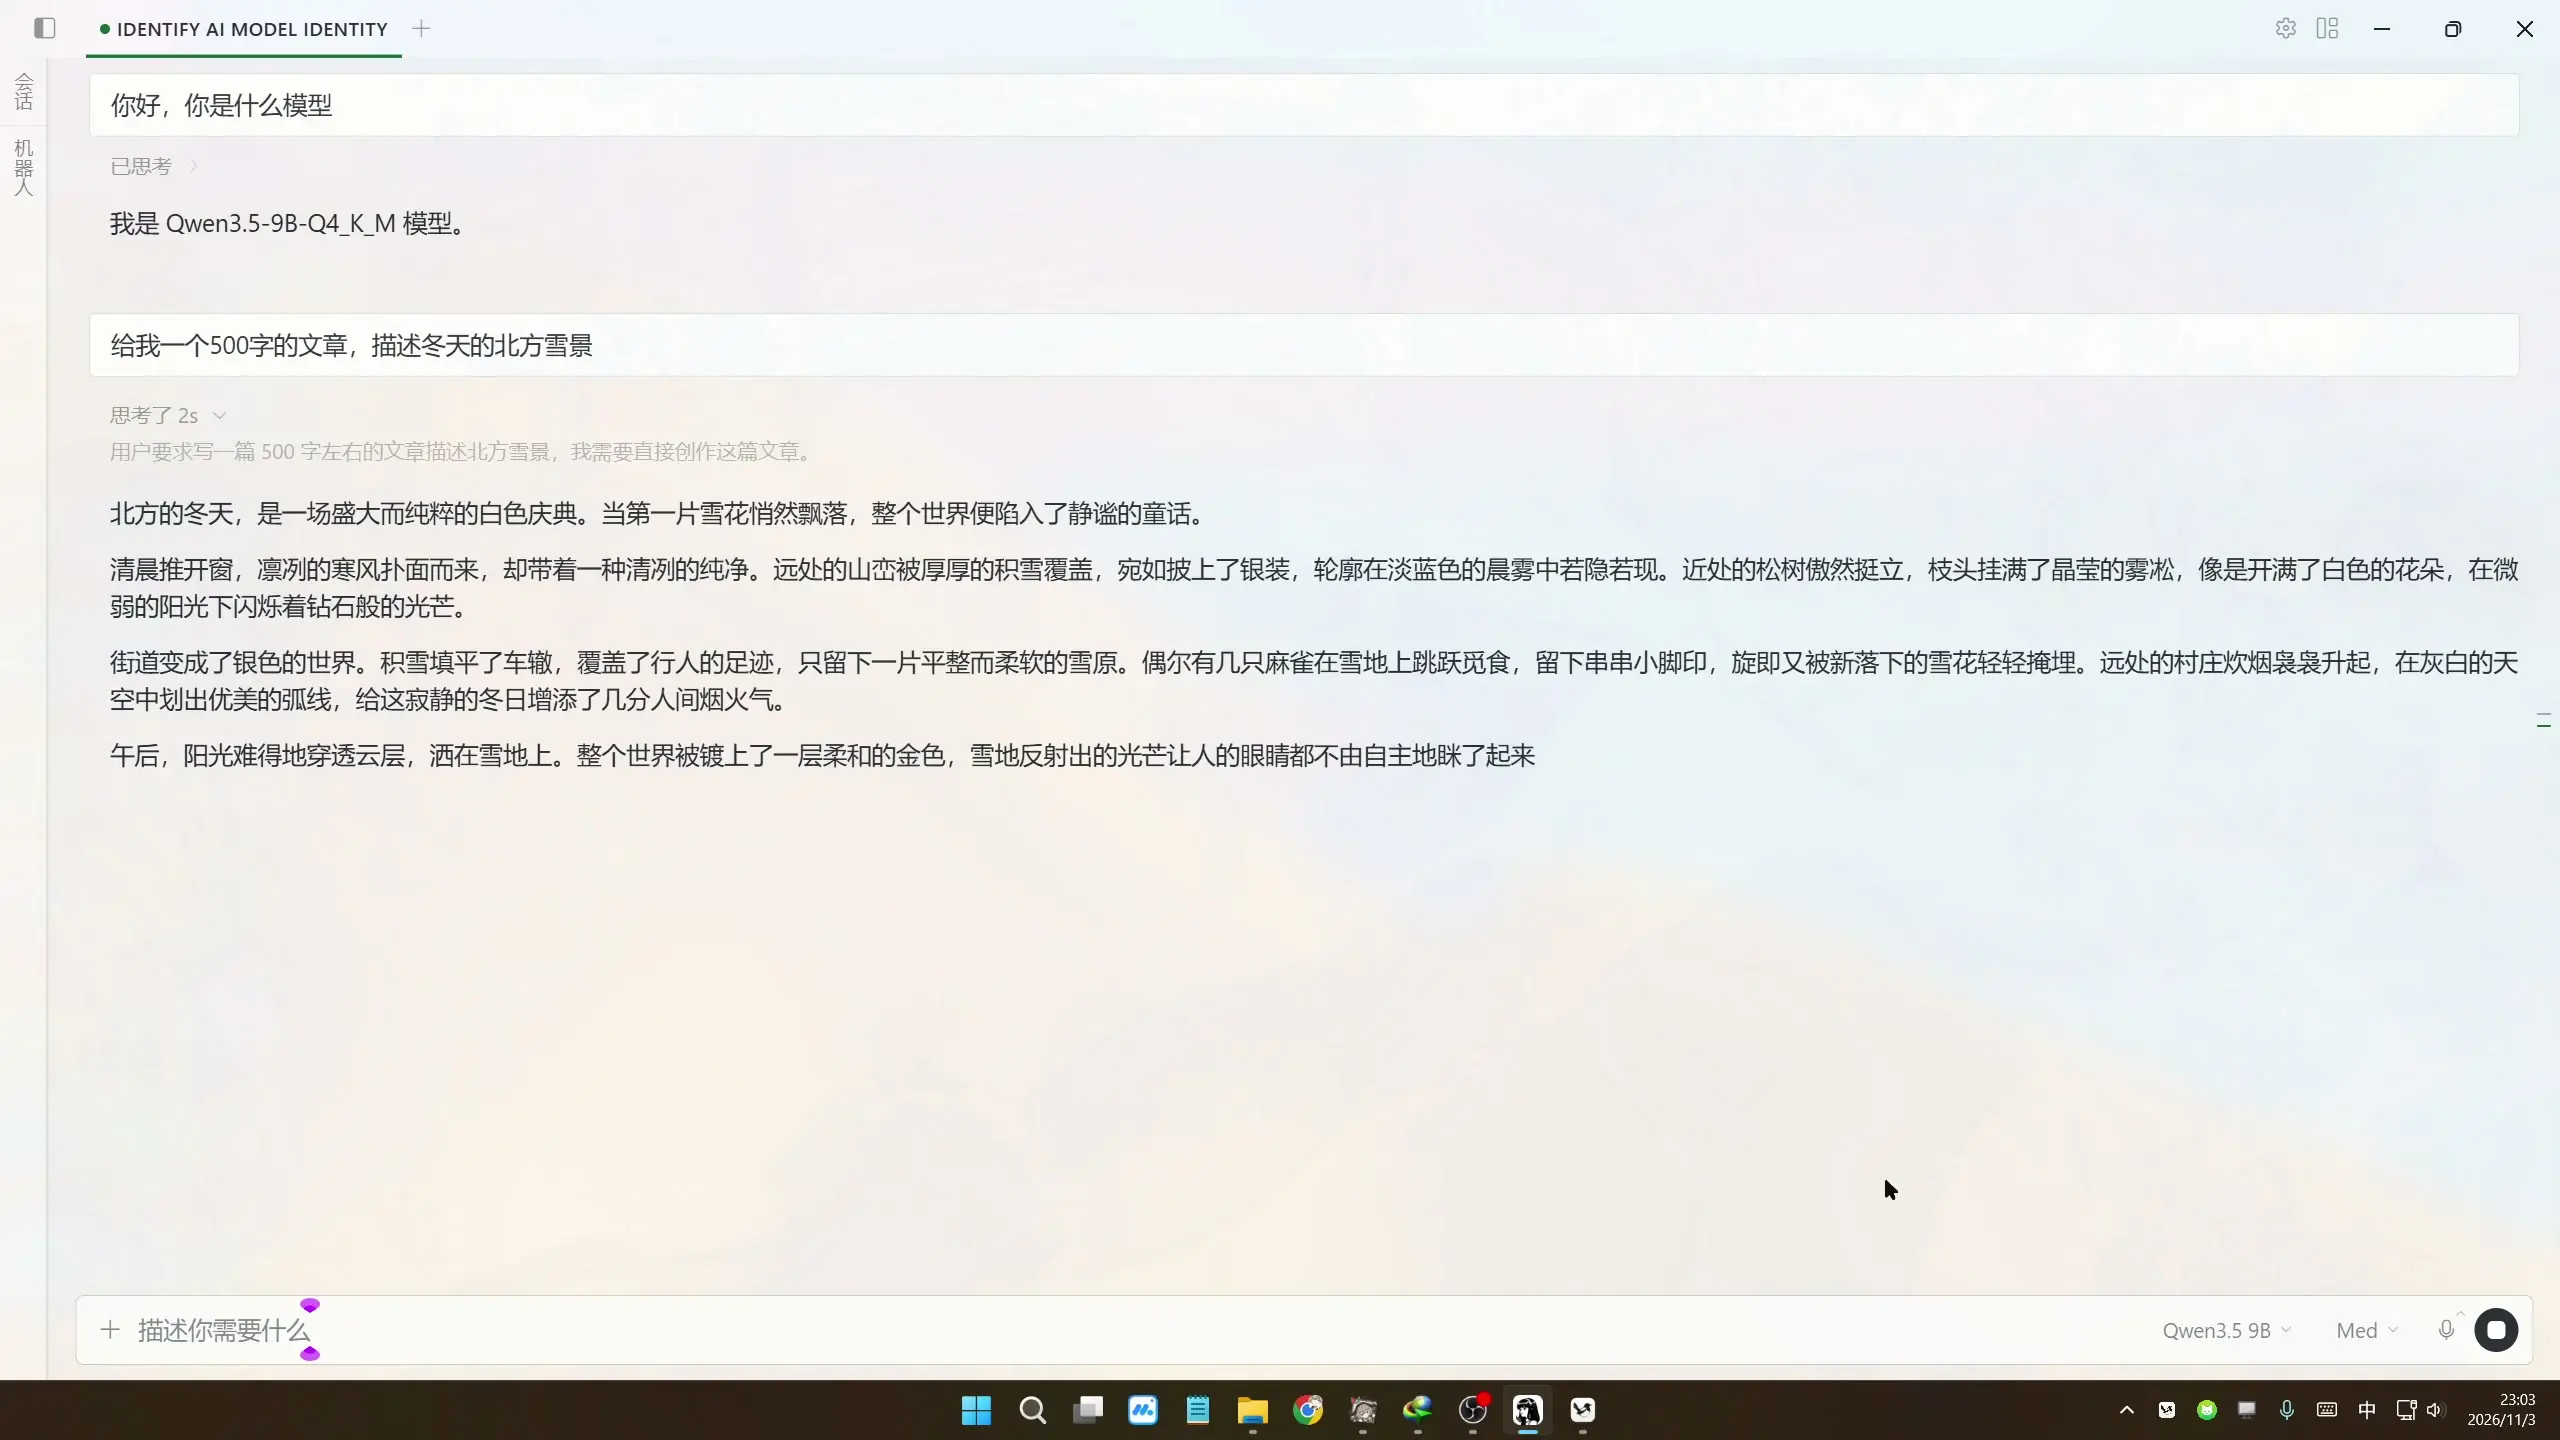
模型几乎没有任何迟疑,第一句就清楚自报家门:我是 Qwen3.5-9B-Q4_K_M 模型。身份没有产生任何幻觉,加载完全正确。
接着我给它出了道考验文学素养与长文本生成的题目:写一篇 500 字的散文,生动描述冬天的北方雪景。它仅仅短暂思考了两秒,随后便流畅地吐出了一篇长达数百字的雪景描摹。文风清冷细腻,从清晨开窗的寒风到积雪覆盖的村落炊烟,辞藻相当自然耐读。
趁着它全速输出,我顺手切出任务管理器瞄了一眼后台硬件监控:
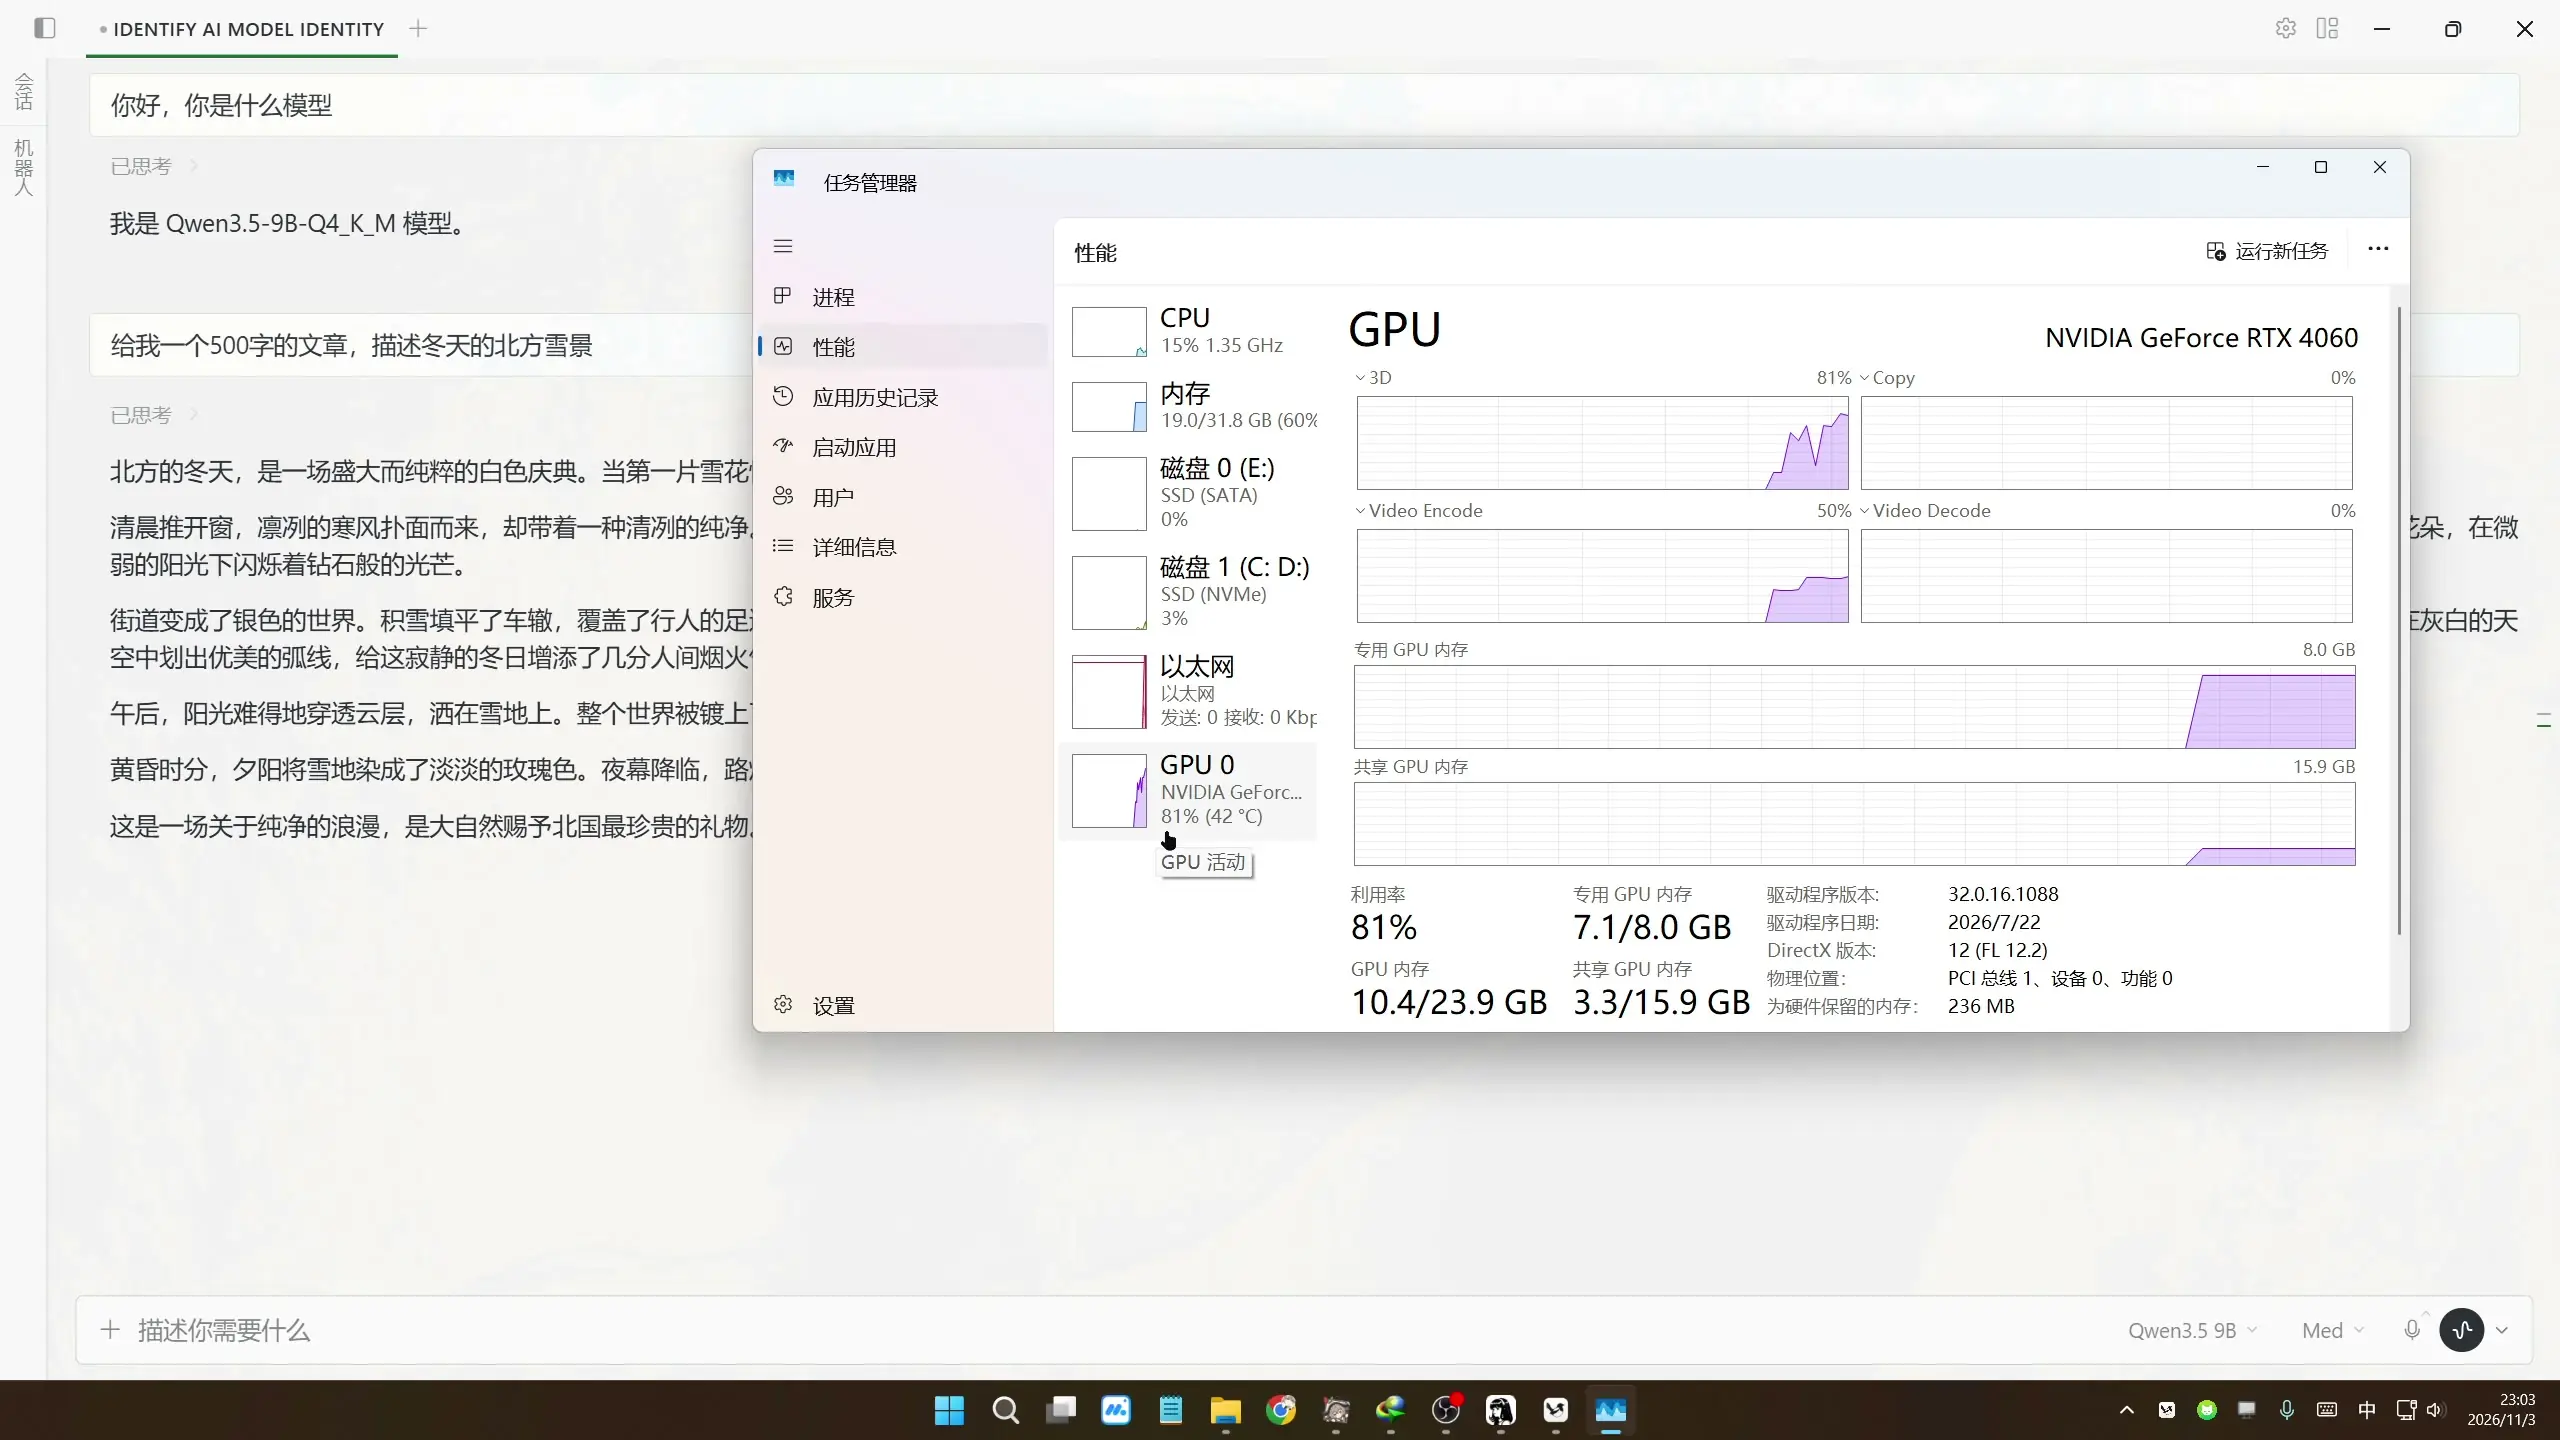
GPU 利用率直接打满到了 81%,专用显存稳稳吃在 7.1GB / 8.0GB 之间。显卡风扇虽然呼呼狂转,但整个显存控制极其精准,丝毫没有溢出到共享内存。
最让人安心的是整个过程的绝对离线。你就算现在把电脑网线彻底拔掉、Wi-Fi 全关,它在本地依然跑得稳如老狗。
5. 进阶实测
如果本地大模型只能打字陪聊,那不过是个好玩一点的打字机。真正的分水岭,在于它能不能具备完整的 Agent 外部工具调度能力。
为了验证这点,我首先给它投喂了一份存放在本地 E 盘根目录下的 意义.docx 文档,要求它阅读全文并提炼核心思想。
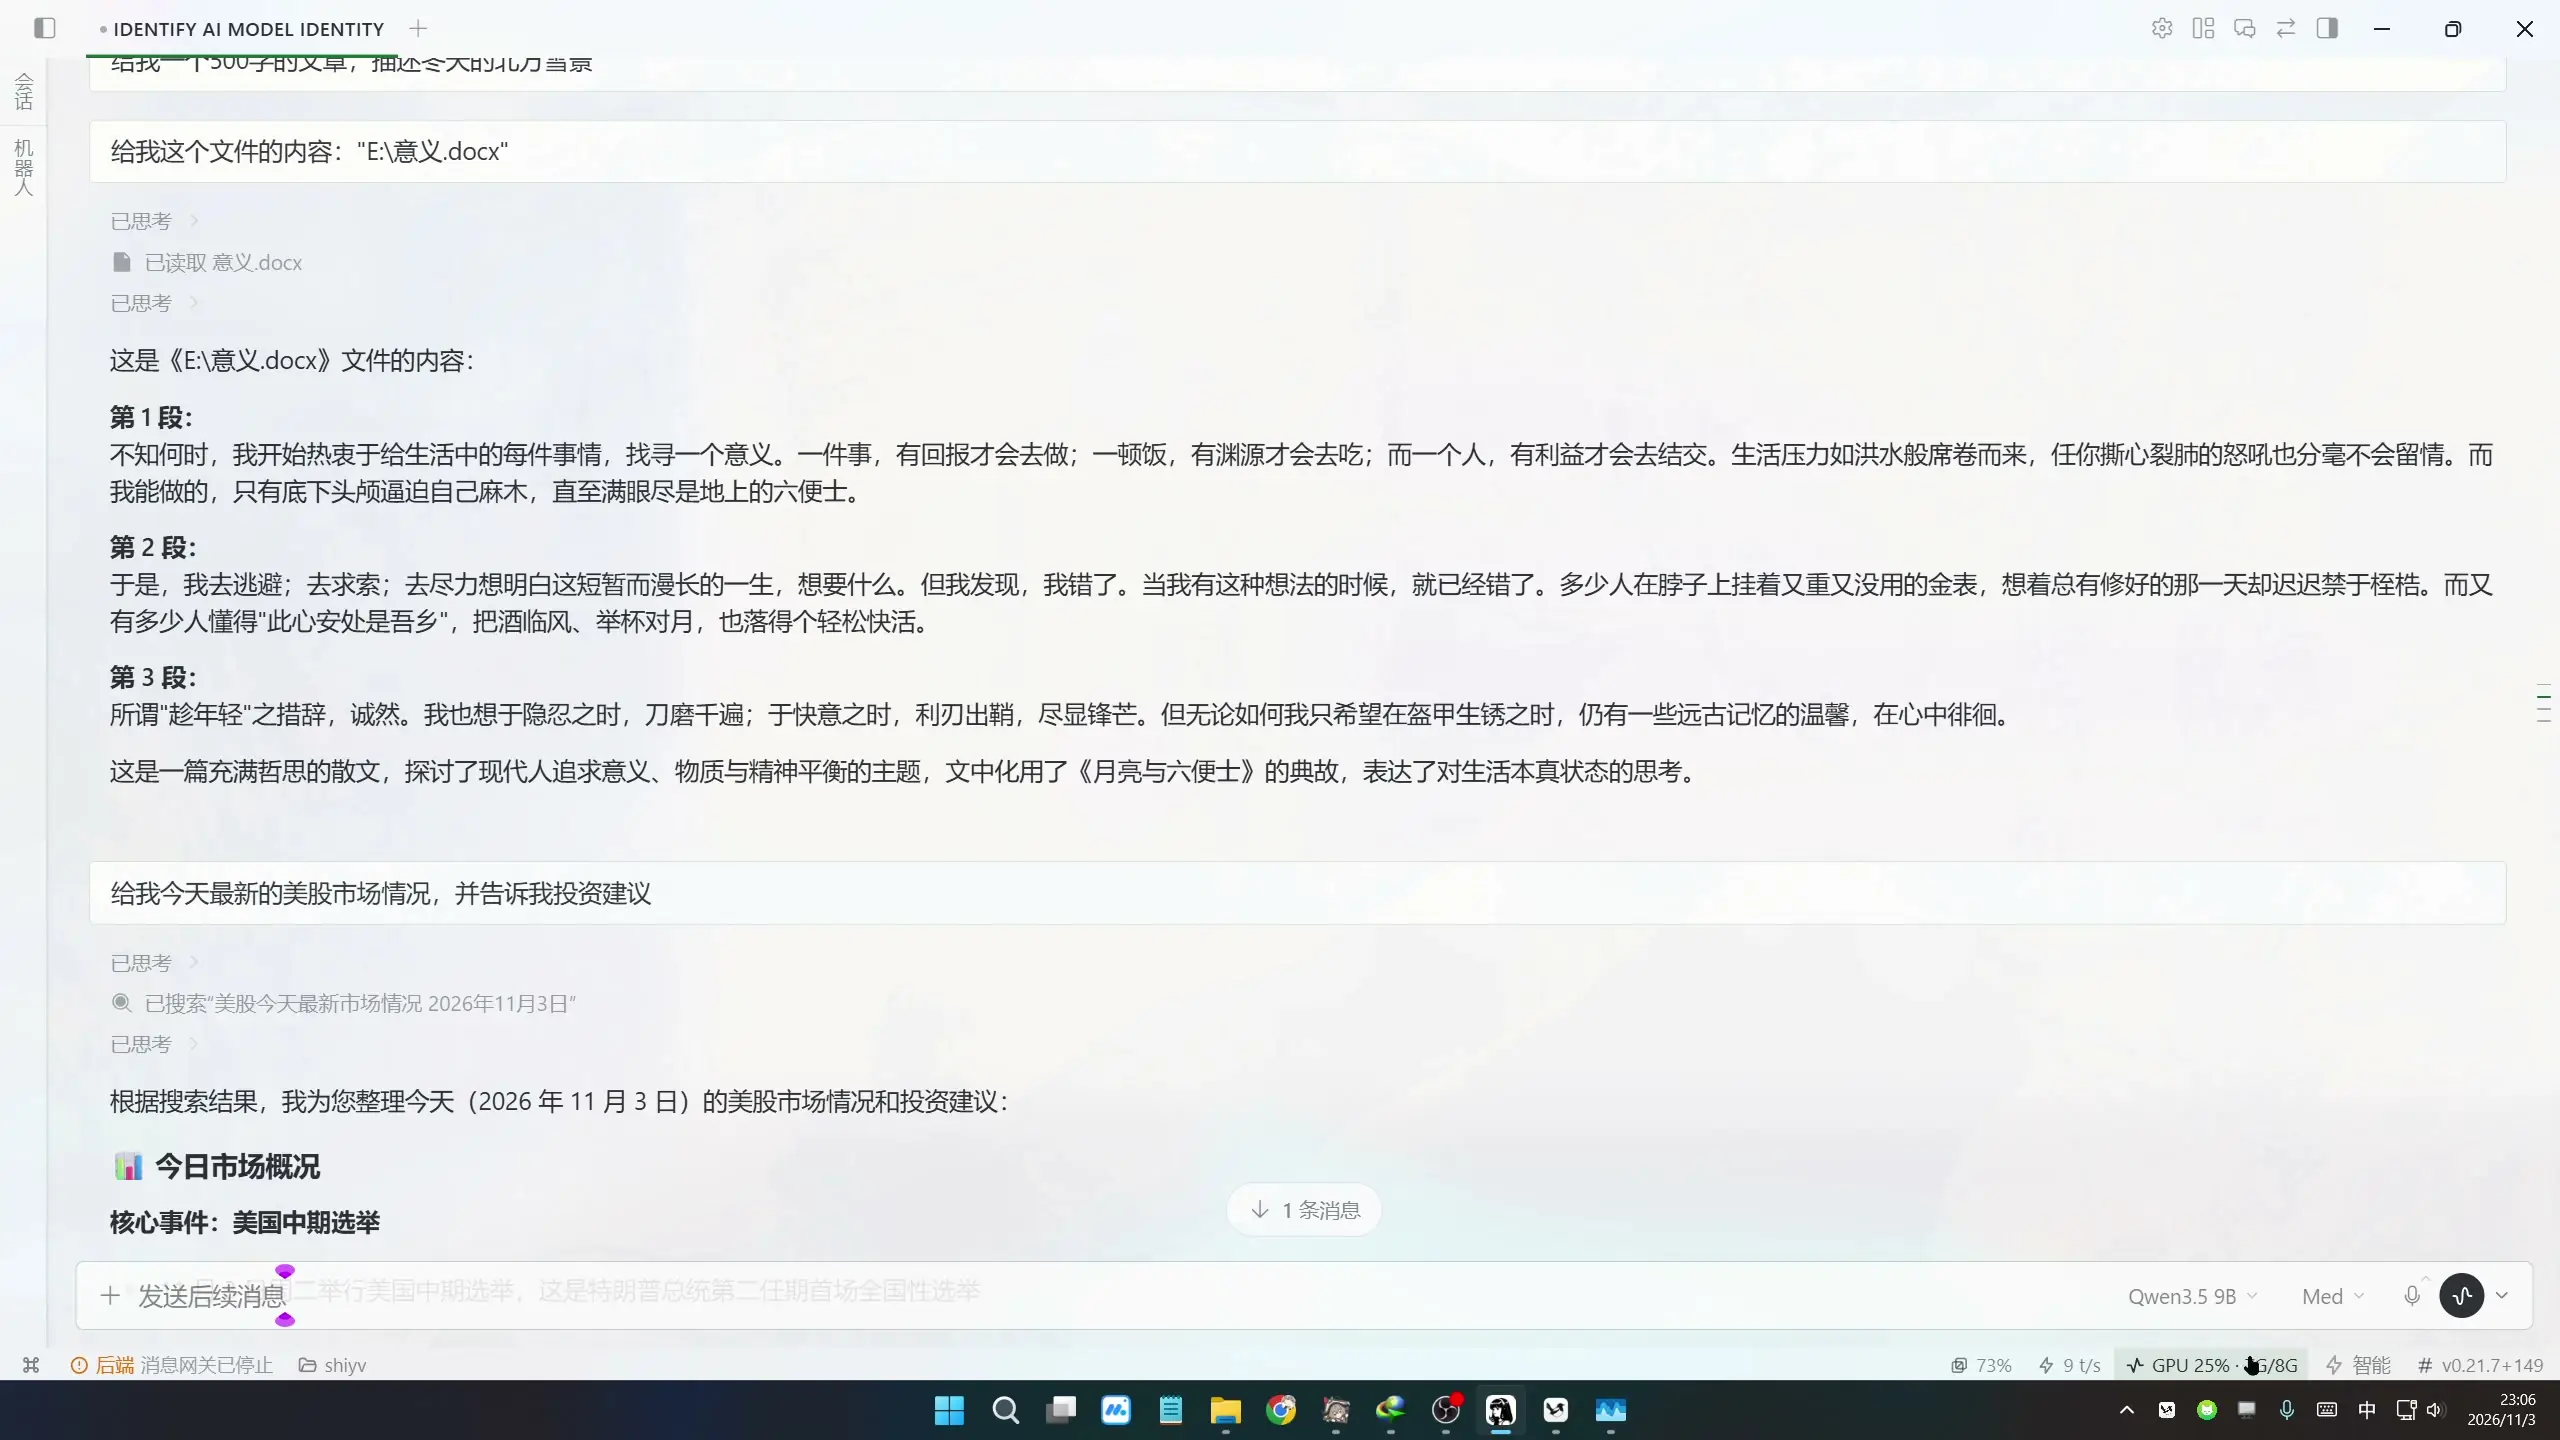
它没有胡编乱造,而是准确触发了内置的 read_file 工具,精准读取了文档中探讨现代人追求物质利益与精神平衡的三段散文,并给出了非常到位的核心主旨概括。
随后我进一步加码,测试它的实时外网检索能力:让它抓取「2026年11月3日美股的最新行情走势,并给出投资建议」。它在后台自动唤醒了搜索模块,片刻之后整理出了包含美国中期选举大盘预期、三大指数波动以及详细的仓位操作策略,日期和事件完全严丝合缝。
这时候我们进入「设置 → 外观 → 窗口和布局」,把界面模式切换为「高级」,就能在底部看到实时性能看板。
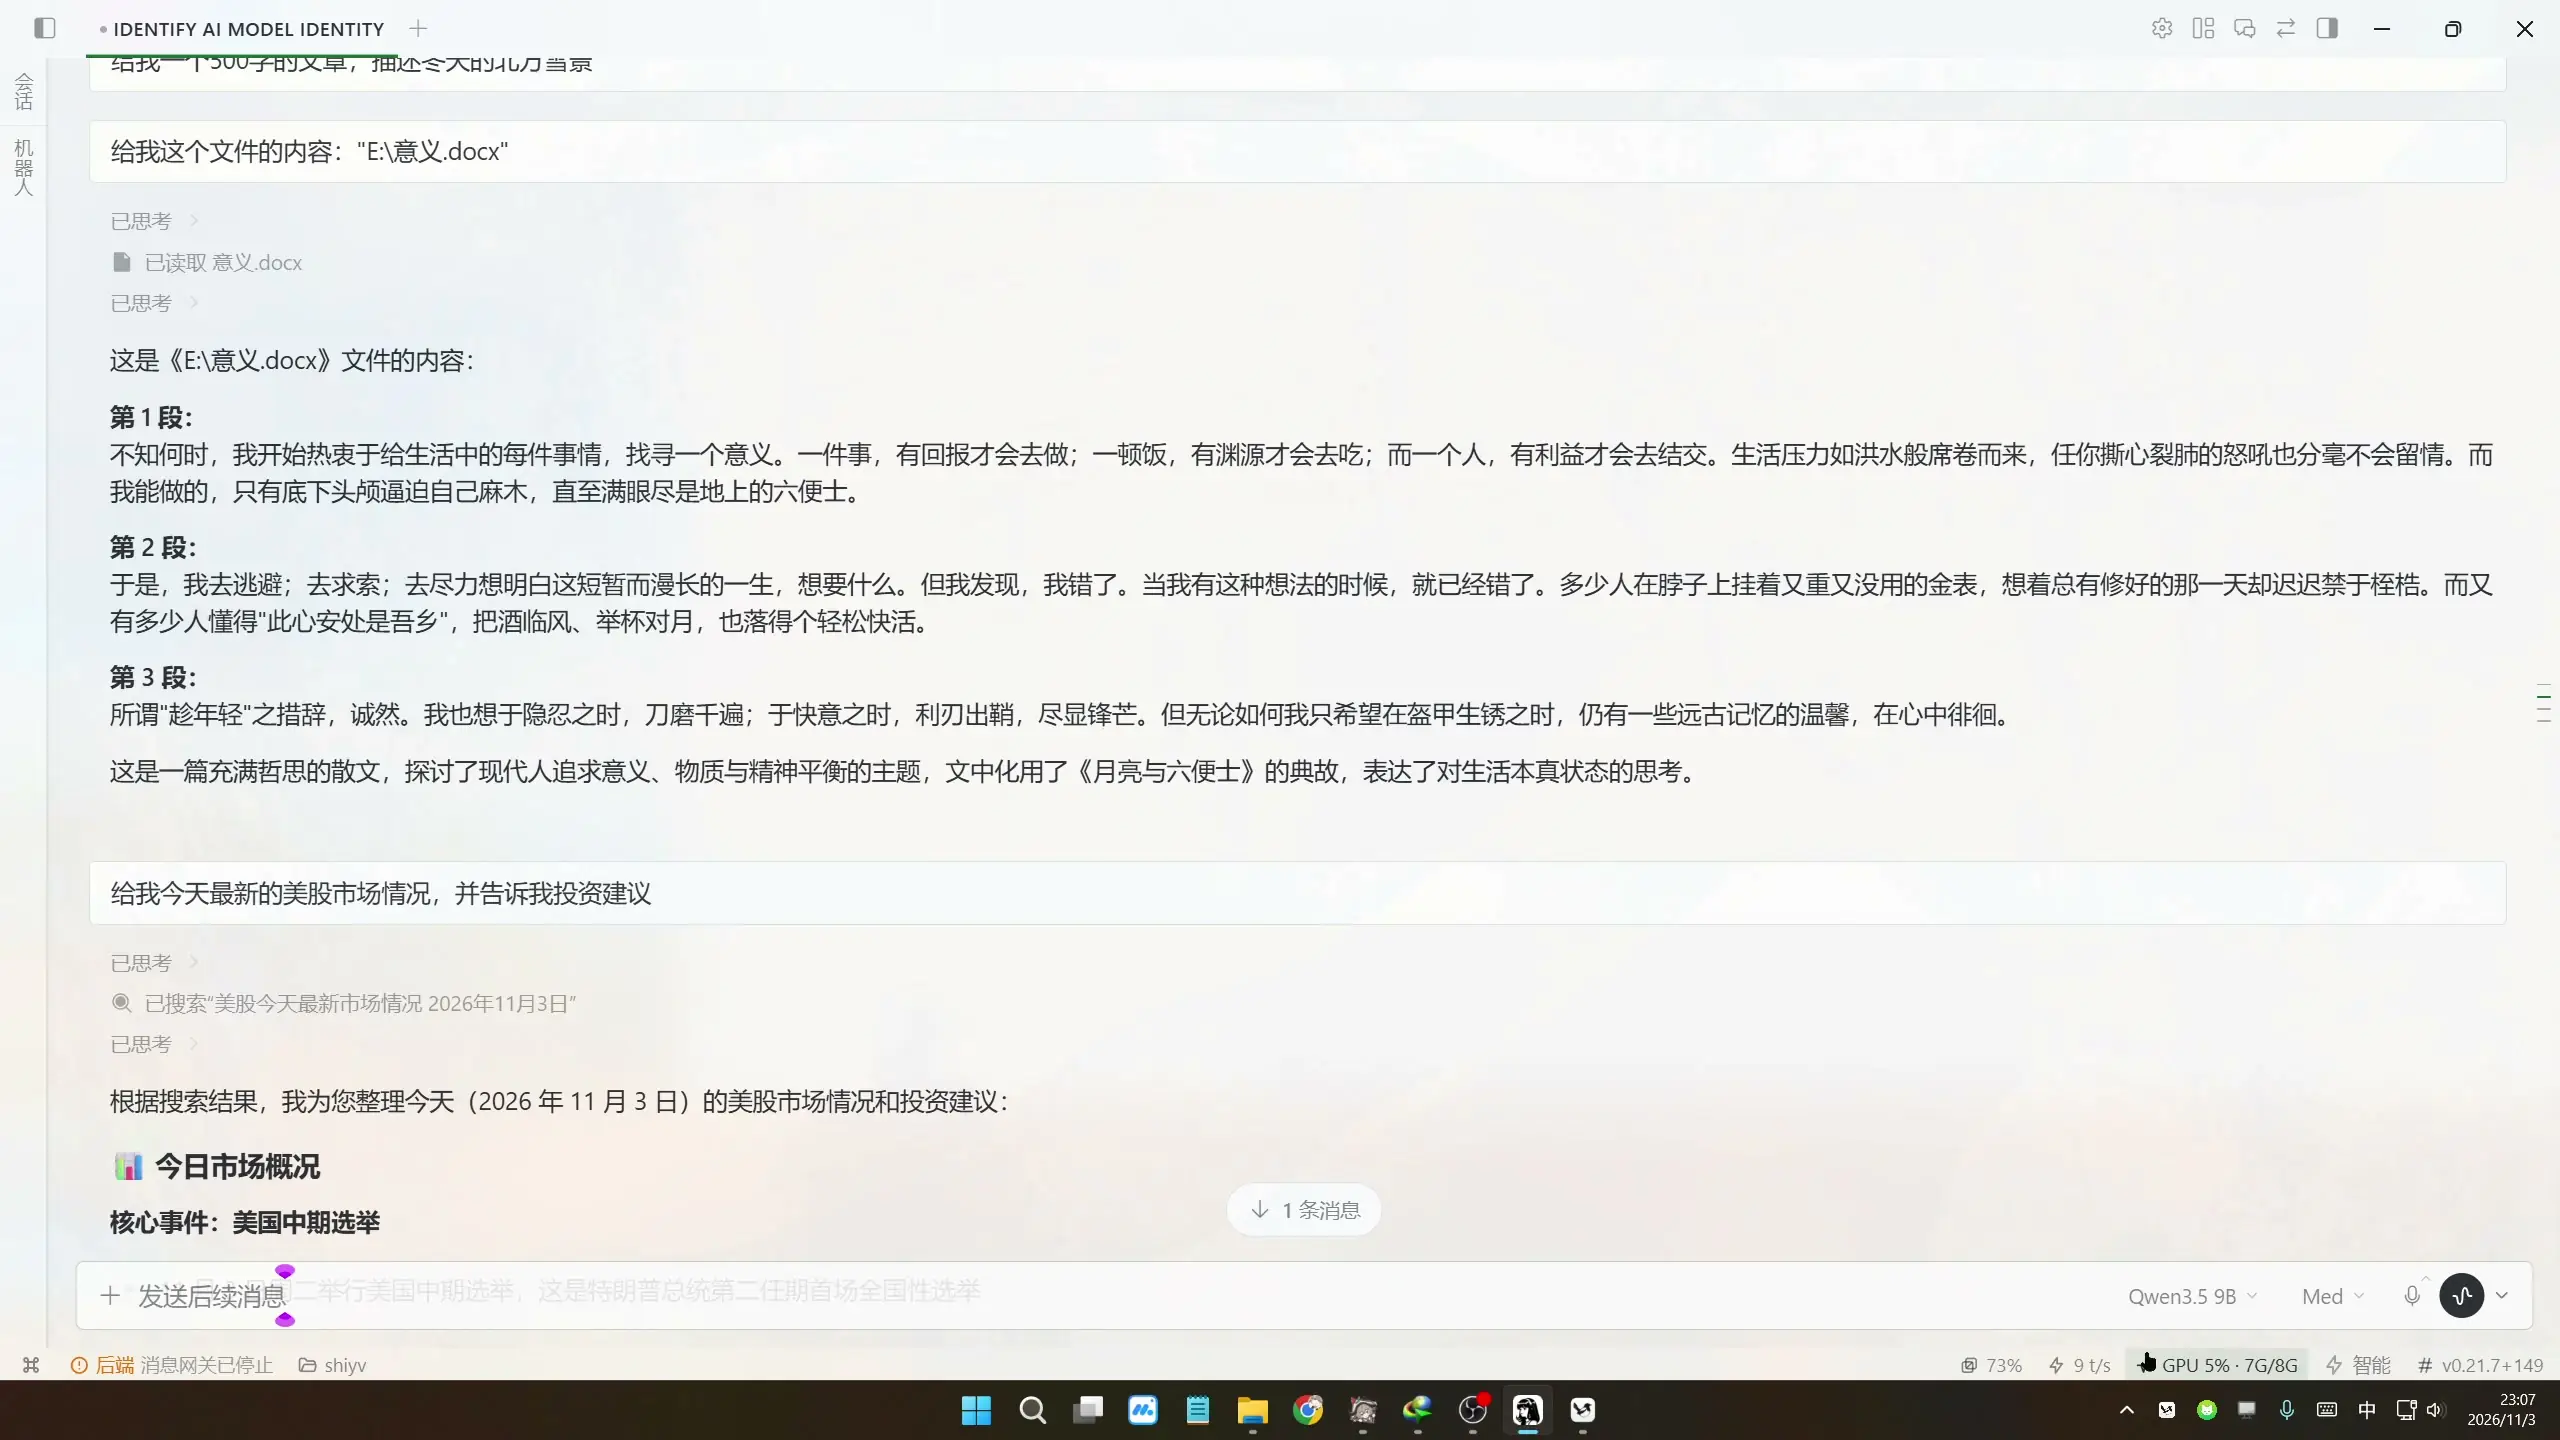
底部状态栏清晰展示了底牌数据:上下文缓存命中率 73%,推理速度稳定在 9.1 TPS,GPU 显存占用 7GB。9 点几的 TPS 虽然不能和云端的极速相比,但在消费级 8G 显卡上,已经达到了踏实干活的及格线。
6. 代码对决
只写写短文和查资料还显不出真本事,我决定给它安排一场硬核的编程拉锯战。
我给出了一个极其抽象、非常考验系统设计能力的综合提示词:帮我编写一个单页网页,用于评估商业模式是否能成功落地;要求设计多维度评分标准,支持用户交互式打分、自动给出评估分数并支持打印导出。
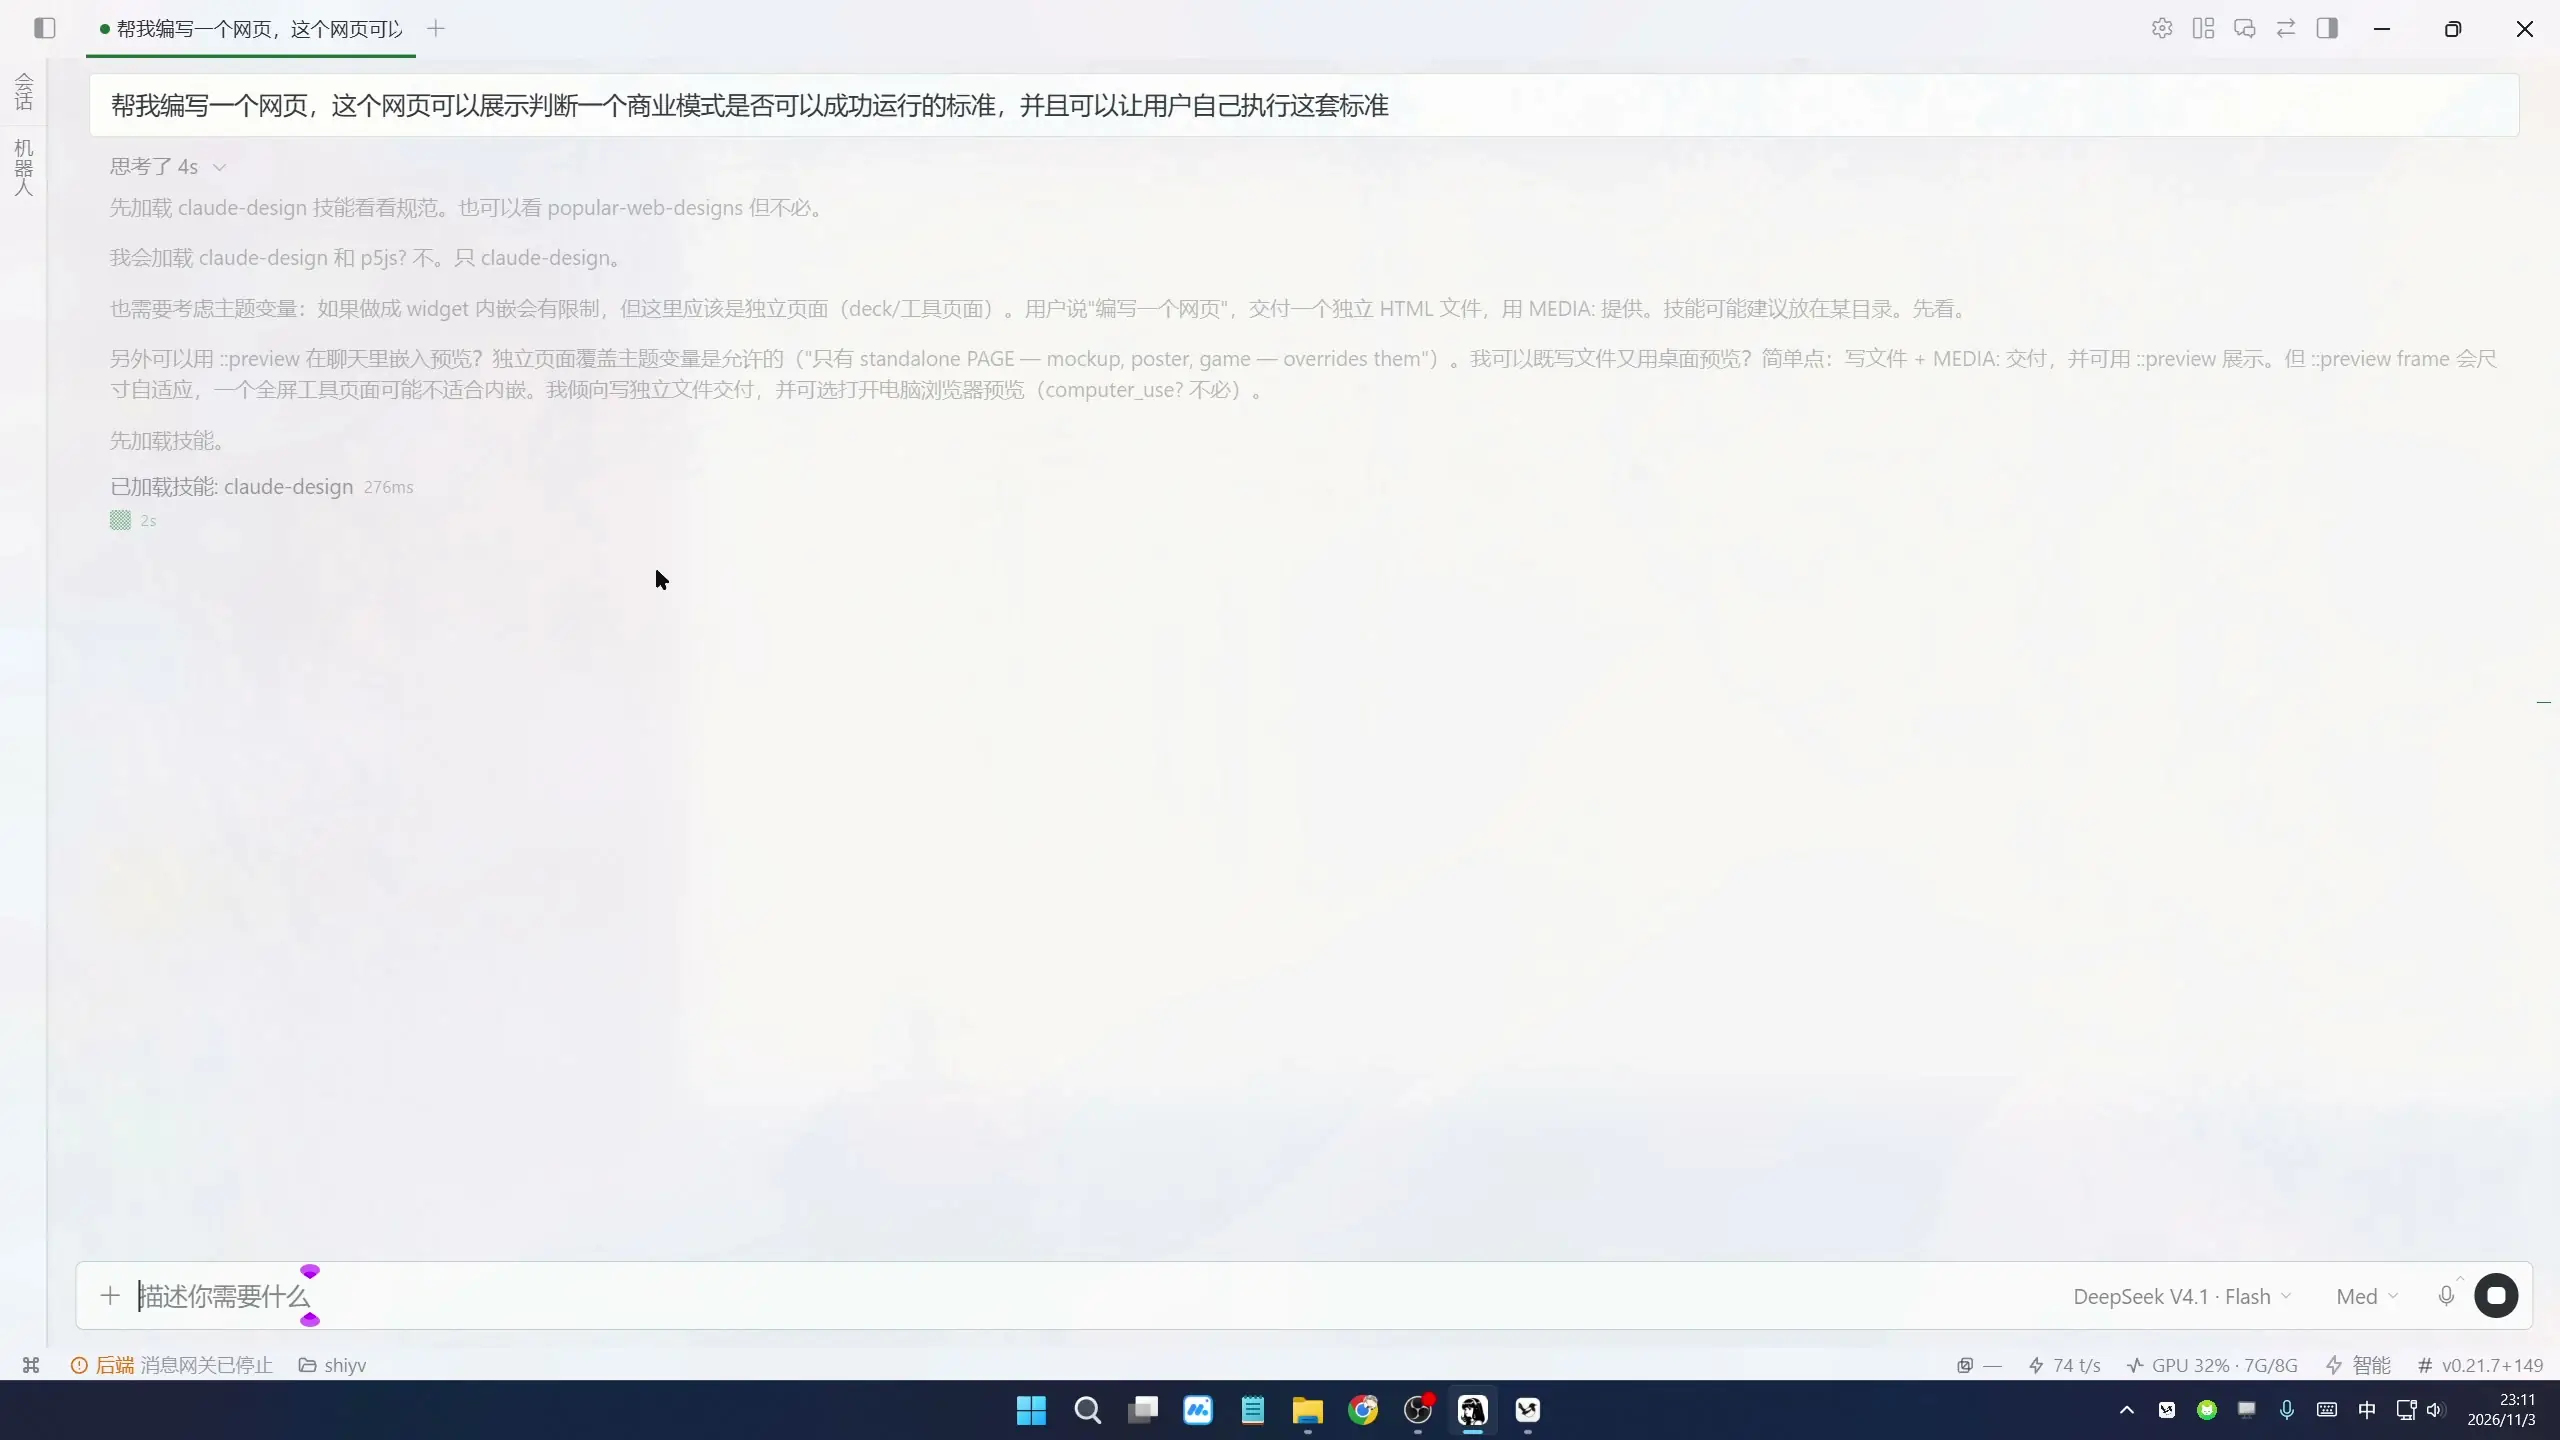
本地模型接单敲代码的同时,我打开了第二个窗口,把一模一样的提示词同时抛给了云端主力模型 DeepSeek V4.1 Flash。
如果你平时也经常开多个窗口同时跑不同的 Agent 写代码,我更推荐搭配之前推荐过的 AI Coding 神器 Herdr,多终端直接在同一个窗口切分,省得到处切屏:
两边一跑起来,差距可以说是肉眼可见:云端 DeepSeek 那边以 63 TPS 的速度一路狂飙,缓存命中率 98%,两分钟不到就交出了一套带精美 CSS 样式的完整代码;而本地 Qwen3.5 这边受制于 9 TPS 的步频,整整啃了 8 分钟才写完。
但当最终双击打开本地生成的 HTML 页面时,结果却大大超出了我的预期:
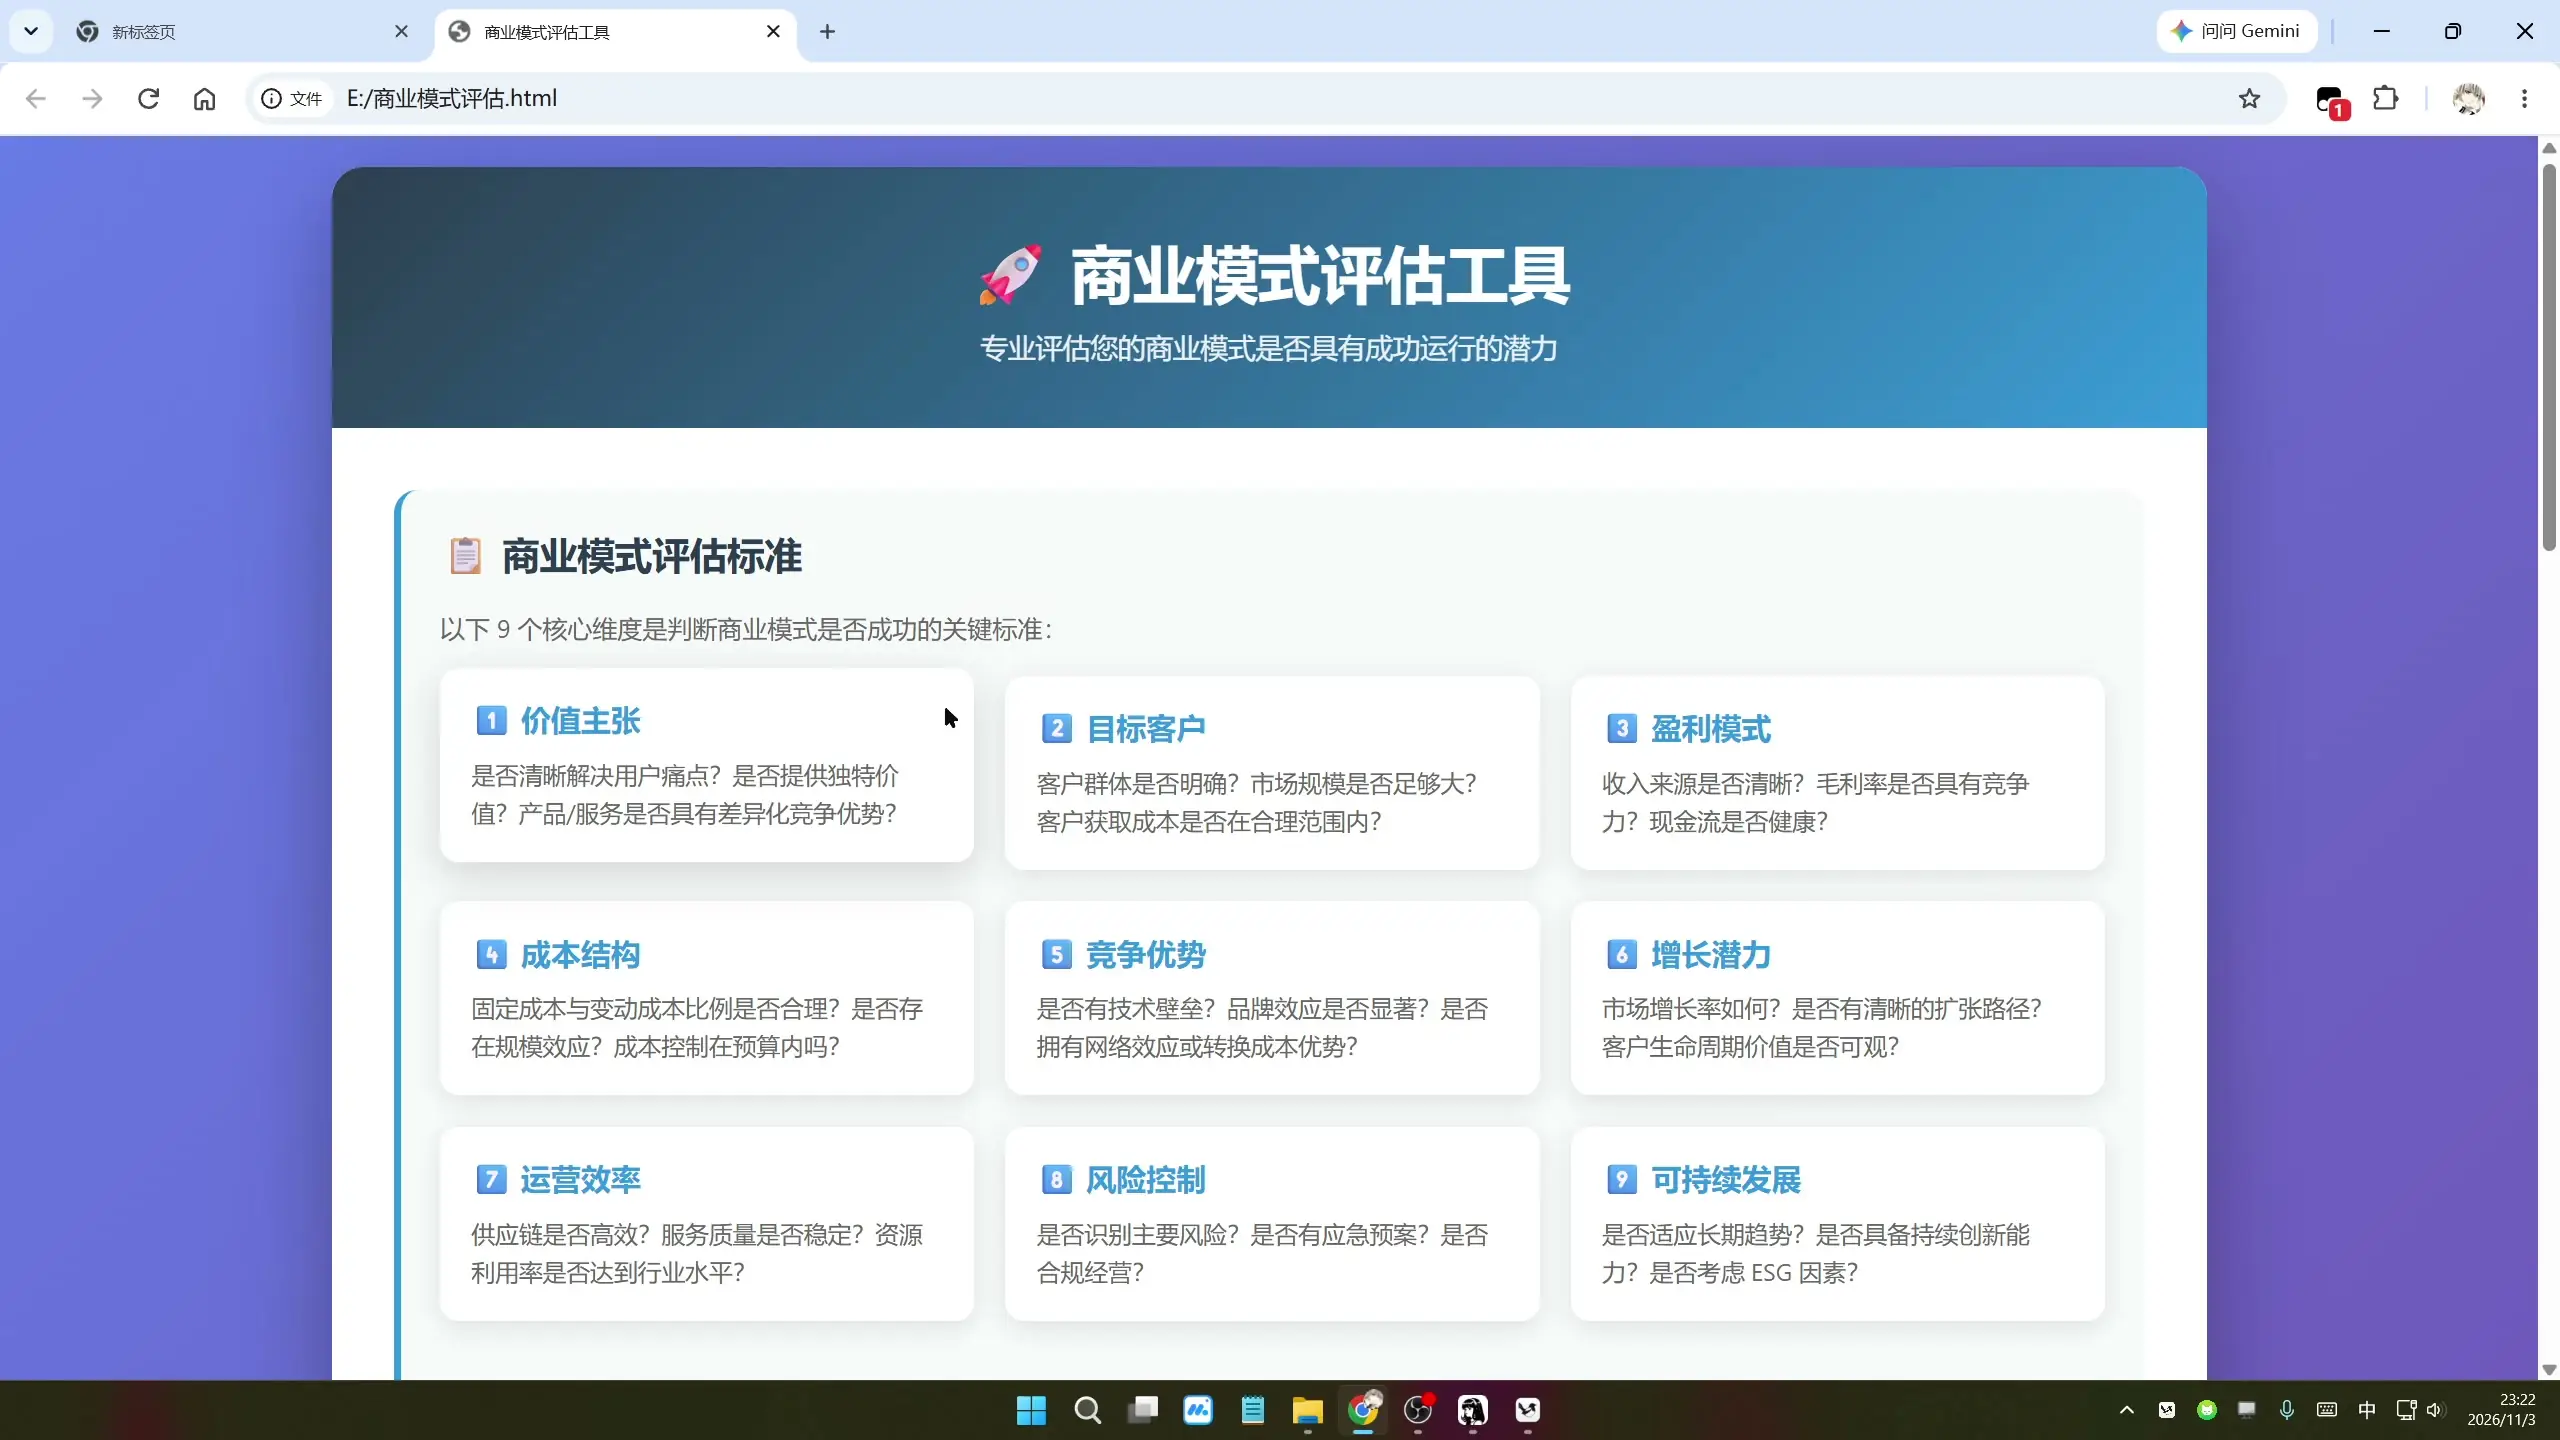
页面虽然非常质朴,谈不上任何高级 UI 设计,但令人佩服的是核心业务逻辑全都在:包含业务类型选择下拉框、价值主张与盈利模式等维度评分、底部的加权总分计算、以及打印导出按钮一应俱全。
麻雀虽小,五脏俱全。
客观来讲:拿它快速写个自用的小工具原型、搭个业务逻辑骨架,它完全能够独当一面;但如果指望它直接产出商业级的成熟代码,现阶段的小参数本地模型确实还不够看。
7. 真实取舍
折腾完这一整套流程,普通人到底有没有必要在自己的电脑里也装一套?我觉得关键看你踩不踩中这两条红线:
- 涉密与安全:如果你的日常工作天天要跟未公开的公司代码、敏感财务报表或者核心客户合同打交道,本地化部署就是不可妥协的底线,速度再慢你也得装。
- 边际成本:如果你每天有海量的数据需要做初筛清洗、批量提取摘要,不想看着 Token 账单心跳加速,本地部署能帮你把这部分基础磨损成本彻底降到零。
要是你的电脑显卡更强悍,拥有 16GB 以上的显存空间,我更建议你直接一步到位上 Qwen3.8 27B,逻辑严谨度和长文本理解力都会迎来质的飞跃。
但要问我日常干活怎么选,我坦白讲:99.9% 的场景下,我依然会毫不犹豫选择云端。
原因很现实:本地模型速度还是偏慢,在处理复杂架构设计时,综合交付质量和云端主流模型相比依然有明显断层,甚至可以说是自欺欺人的水平。它最舒服的定位,就是一个断网备用兜底、涉密资料处理器或者写写短文的小助手;剩下 99% 的重活,交由成熟的云端链路才是最明智的选择。
而且现在的云端模型生态,价格早就被卷得极度亲民了。比如我的中转站 api.appstoy.com,不仅有门槛极低的免费福利分组,付费线路上跑 0.05 倍率的满血 ChatGPT,成本也低到了几乎可以忽略不计。
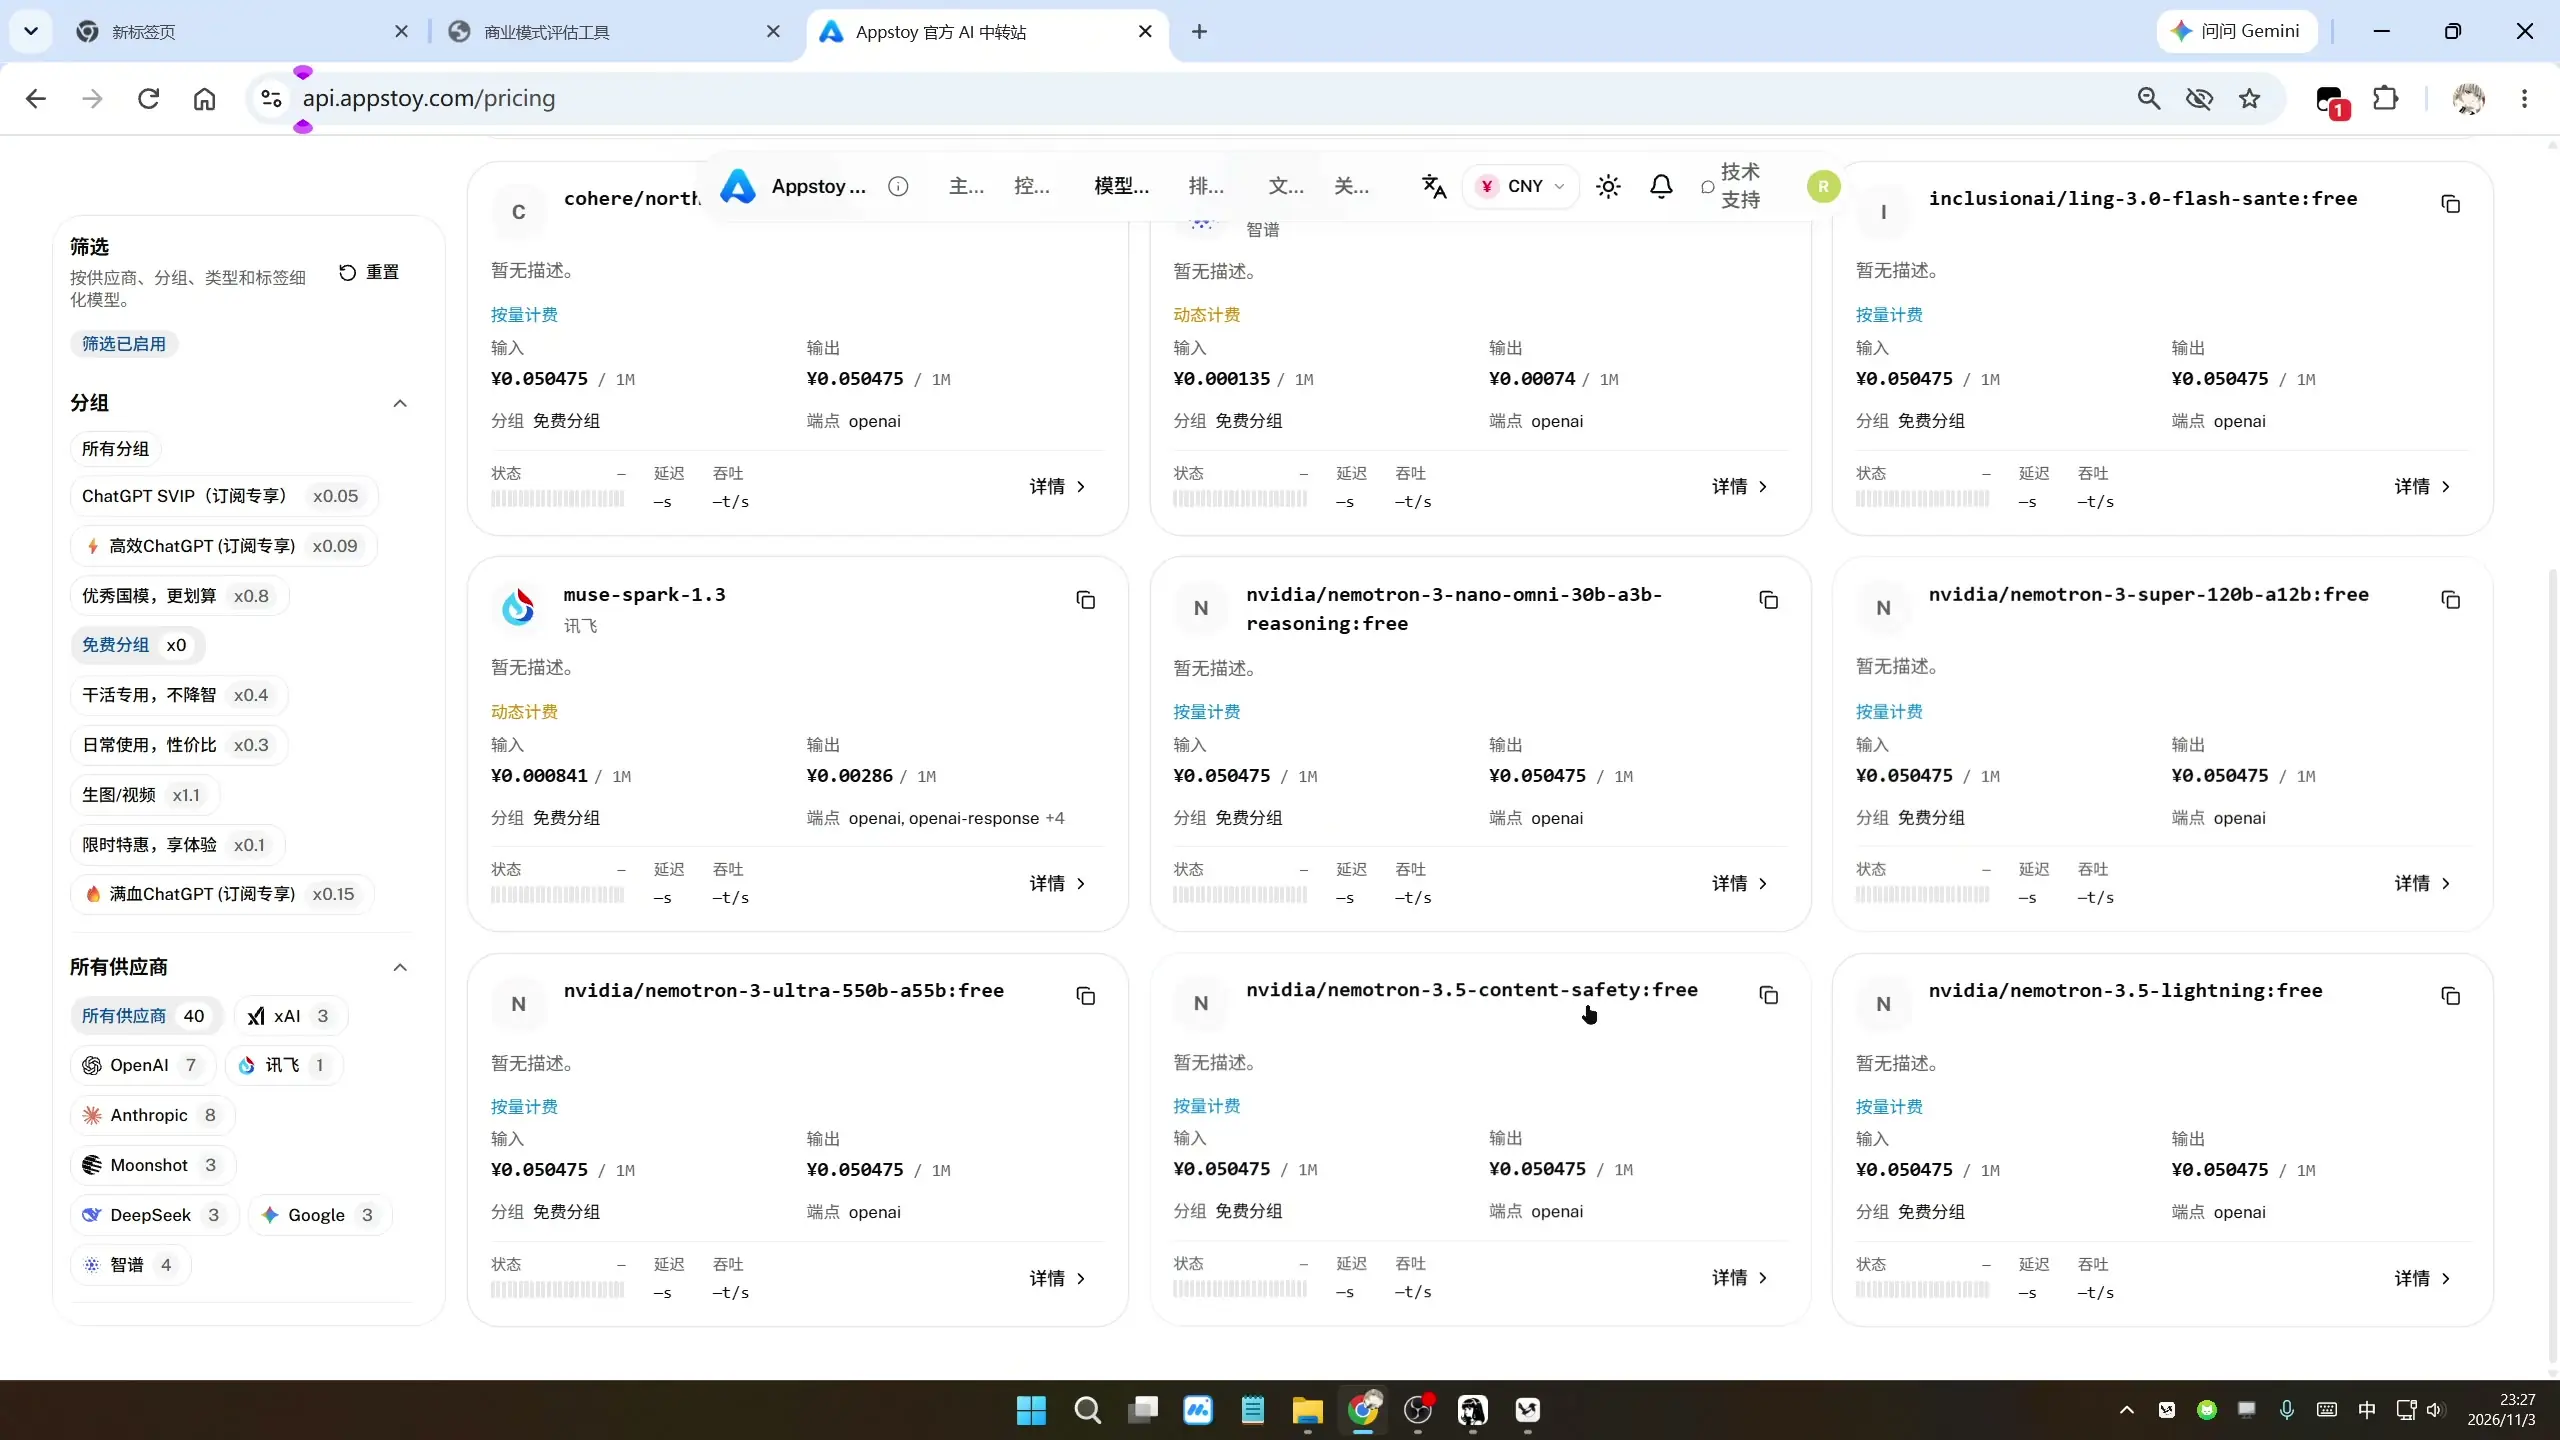
平时写代码我就用新出的 GPT-6.1 Terra,价格实惠且响应奇快;遇到关键的大型系统重构,再换上 GPT-6.1 Sol 或者 GPT-6.1 Astra,兼顾逻辑缜密度与代码质量。
挑模型这事,我一般只看三点:价格、速度和质量,只要能占住其中两样,用起来就稳如老狗。
8. 避坑指南
最后整理三条实打实的踩坑经验,帮大家少走弯路:
- 别盲目贪大参数:8G 显存老老实实选 9B 量化版,硬上 27B 会导致内存频繁置换,速度会慢到让人怀疑人生。
- 首次加载有耐心:第一次点击对话时模型需要完整加载进显存,显卡风扇狂转几十秒是正常现象,千万别以为是死机或者装坏了。
- 善用上下文缓存:同一个话题下连续提问,第二次往后的响应往往会快很多,因为大部分历史 Token 已经被缓存锁定了。
装不装,大家按照自己的实际需求和账本去算。用得上它就是断网神器,用不上它也就是硬盘里一个几 G 的静态权重包。
本文由 Appstoy 原创发布,主要分享优质软件、 AI 工具、效率提升技巧以及实用技术教程。
本站所有原创内容均经过实际测试与整理, 欢迎分享文章链接,转载请注明来源: Appstoy
如需转载、引用本文内容或进行商业合作,请提前联系本站。


暂无评论内容